요약
스텝펀이 에이전트 작업용 플래그십 모델 Step 5 Preview를 OpenRouter에 내놓았습니다.
여러 회사의 AI 모델을 한 API로 쓰게 해 주는 OpenRouter에 10월 8일 새 모델 페이지가 열렸습니다. 스텝펀은 이 모델을 큰 코드베이스와 문서를 오가며 도구를 쓰고 결과를 여러 번 다듬는 긴 작업용으로 설계했다고 소개했습니다.
왜 중요한가
- 스텝펀이 그동안 OpenRouter에 올린 Flash 계열(전체 1,960억 개)보다 세 배 넘게 큰 모델입니다.
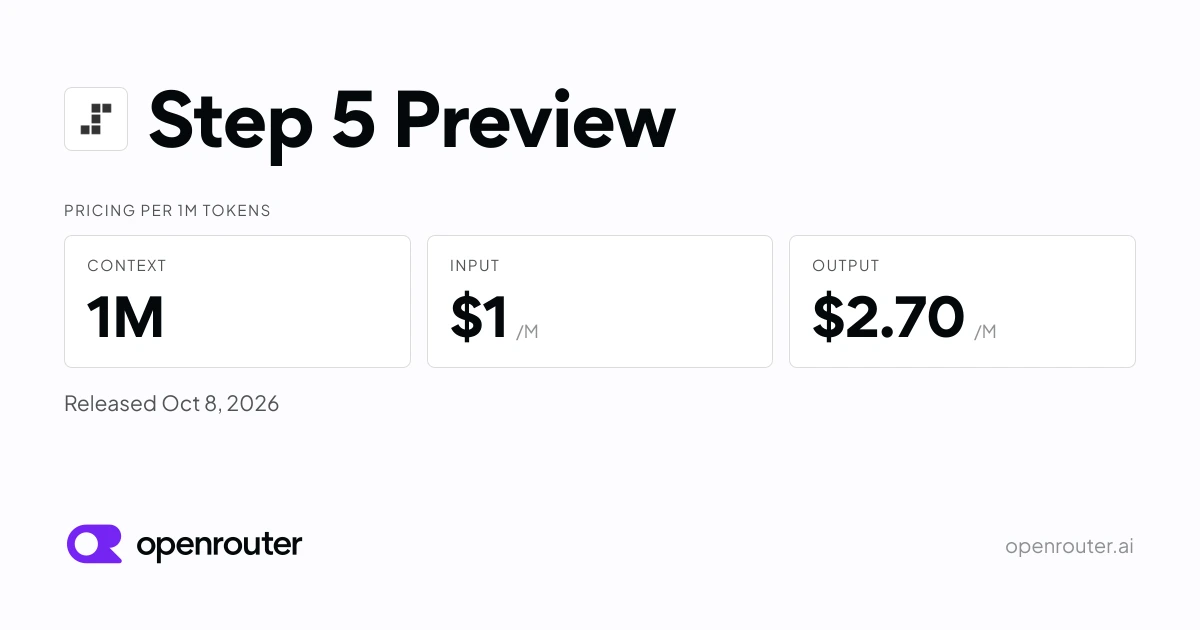
- 100만 토큰 컨텍스트를 입력 100만 토큰당 1달러에 쓸 수 있어 긴 문서와 코드를 다루는 작업에 새 선택지가 생겼습니다.
- 공개 첫날에만 입력 토큰 4,370억 개가 처리될 만큼 OpenClaw, Cline 같은 에이전트 도구가 바로 붙었습니다.
핵심 내용
- 전체 매개변수는 6,000억 개지만 토큰마다 270억 개만 계산하는 희소 MoE(전문가 혼합) 구조입니다.
- 컨텍스트 창(한 번에 넣을 수 있는 입력 길이)은 100만 토큰이고, 최대 출력은 6만 4,000토큰입니다.
- 가격은 100만 토큰당 입력 1달러, 출력 2.7달러이고, 캐시 읽기는 0.05달러입니다.
- 소프트웨어 개발과 전문 지식 업무에 강하며, 특히 금융 분야에서 성능이 좋다고 밝혔습니다.
- 지금은 스텝펀 한 곳만 서비스하며, 구조화 출력(정해진 형식으로 답하기) 오류율은 평균 13.46%로 집계됐습니다.
HN 반응
- 모델 비교 사이트 Artificial Analysis를 근거로 어느 면에서도 경쟁력이 없다는 평가와, GLM 5.3·Kimi K3와 비슷한 점수에 더 빠르다는 반론이 맞섰습니다.
- 이전 Step 모델은 128GB 메모리 장비에서도 잘 돌았지만, 이번 모델은 너무 커서 직접 돌리기 어렵다는 아쉬움도 나왔습니다.
펠리컨이 없으니 뭐라고 판단해야 할지 모르겠네요.
https://postimg.cc/c6L2MjSt
12분 0초, $0.28
사람들이 자꾸 그러니 말해 두는데, 새 LLM이 나왔다는 해커뉴스 스레드가 뜰 때마다 Simon의 펠리컨을 들먹일 필요는 없습니다. 레딧 밈보다도 노력이 덜 드는 농담이에요.
저는 그냥 사회적 마찰로 받아들일 거예요. 당신의 댓글도 똑같이 사회적 마찰로 보이고요.
본질적으로 합의 메커니즘이 제 할 일을 하고 있는 겁니다.
__
물론 공정하게 말하면, 제 설명은 노드들 사이에 연결이 없고 각자 독립적으로 선택한다고 가정하는데, 실제로는 서로 편을 들어 주는 집단이 있죠.
그래서 꼭 최선의 메커니즘이라고는 할 수 없어요. 사회적 결속이나 그런 기능 이상 때문에, 꼭 합리적이라고 할 수 없는 편향을 통해 객관적으로 올바른 답에서 멀어질 수도 있으니까요.
아니, 정확히는 특정한 맥락만 놓고 보면 합리적이지 않을 수 있어도, 한 발 물러나 하위 시스템 전체의 건강을 생각하면 합리적일 수도 있겠죠.
해커뉴스에서는 사이트의 질을 떨어뜨리기 때문에 노력이 거의 안 든 콘텐츠를 대체로 권장하지 않습니다. 사회경제학에 대한 심오한 논평 같은 게 아닙니다.
새 모델이 나올 때마다 똑같은 퍼스널 브랜딩 글을 올리는 것 같은 걸 말씀하시는 거죠?
말했듯이 여기에 옳고 그름은 없어요. 아니, 엄밀히 따지면 있고 그건 제 의견이긴 하지만(당연히), 한 발 물러나서 보면 방금 제가 설명한 바로 그대로인데 당신이 (안타깝게도) 밀어붙이면서 묵살해 버렸네요.
""""사상가""""라는 분들은 자기 작업이 별로 가치를 더하지 않는다고 생각하는 사람도 있다는 사실을 받아들이며 살아야 할 거예요. 자존심에는 좀 불쾌한 일이겠지만, 알맹이 없는 걸로 돈을 벌려면 그 정도는 감수해야죠.
OP가 이미지를 추가한 수정본에 대해 말하자면, 기분 나쁘기보다는 그냥 좀 어이가 없네요.
저는 펠리컨을 펭귄만큼은 아니어도 꽤 좋아해요. 언젠가 minimaxir의 맥스 긍정(max positive)을 볼 날이 오겠죠 ;)
더 나은 대안이 있었는데, 멍청한 HN 검열 때문에 묻혔습니다.
The Assbench: https://news.ycombinator.com/item?id=49807688
Simon Wilson 님 호출합니다!
이름을 제대로 쓰면 아마 더 빨리 답해 줄걸요.
제가 보기엔 Step 모델이 128GB 공유 메모리에서 돌릴 수 있는 로컬 모델 중 처음으로 제대로 쓸 만했습니다. Qwen Flash Next와 비교하면 어떨지 정말 기대됩니다.
수정: 아쉽네요, 600B-A27B인 줄 몰랐습니다. 228GB로는 돌릴 방법이 없습니다.
Artificial Analysis 기준으로는(솔직히 저는 직접 모델을 비교하기 귀찮아서 이걸 일종의 정신적 목발처럼 쓰고 있으니 감안하고 들으세요) Gemini 3.8 Flash보다 똑똑하고 값도 약간 쌉니다. 저한테 "싸면서 충분히 똑똑한" 모델의 기준선이 Gemini 3.8 Flash였거든요. 이번 주 동안 OpenCode에서 한번 써 볼 생각인데, Muse Spark 1.3에서 갈아탈 만큼 끌릴지는 잘 모르겠습니다.
이게 왜 흥미로운 건가요?
Stepfun은 3.5로 SOTA에 가까운 모델을 만들었습니다. 금세 추월당하긴 했지만, 새 모델이 나올 때 주목받을 만큼은 보여 줬습니다.
게다가 오픈 모델이기도 합니다. Opus와 Sol만 쓰는 사람이라도 이런 오픈 모델이 그들과 최전선을 밀어 올리는 데 도움이 됩니다.
나왔을 때는 같은 시기에 새 Qwen 모델이 워낙 많이 쏟아져서 별로 주목을 못 받은 모델 같습니다. 제 Strix Halo 장비에서 좀 써 봤는데, 메모리에 간신히 들어가는 수준이었어요.
3.5 Flash는 괜찮았는데, 저는 OpenRouter로 썼습니다. 요즘은 Strix Halo에서 어떤 모델을 돌리시나요?
Qwen-3.8-flash-next @Q4입니다.
3.5/3.7 시절[1]에 이 회사는 작고 빠른 모델을 내놨는데, 지식은 일부러 포기하고 도구 호출 관리나 서브 에이전트 조율 같은 "범용 지능"에 집중했습니다. 개인 비서를 돌리는 기반으로 아주 좋을 수 있어요(어떤 접근이 맞는지는 시간이 말해 주겠죠). 그래서 그때 이후로 얼마나 발전했는지 직접 써 보고 싶습니다.
[1] https://news.ycombinator.com/item?id=47069179
뭐, 지금은 무료니까요. 그 뒤로는 글쎄요.
혹시 이게 space bunny alpha 모델이었나 싶네요.
간단히 테스트해 보니 아닌 것 같습니다. 게다가 Space Bunny Alpha는 Minimax 계열 모델이라는 단서가 있었고요.
적어도 2주 전부터 ZenMux에 올라와 있었으니 숨기고 있는 건 아닐 겁니다.
새 모델을 써 보는 건 좋아하지만, 진짜 새로운 걸 좀 봤으면 좋겠어요. 새로운 아키텍처 같은 거요. LLM은 너무 슬롭 같아요. 우리는 더 잘할 수 있어요.
말로는 뭘 못 합니까. 먼저 트랜스포머를 실제로 이겨야죠. 지금까지 나온 대안 아키텍처는 기껏해야 사이드그레이드(성능이 비슷하거나 일부만 나은 수준)입니다.
트랜스포머보다 나은 게 있긴 합니다. 다만 투자를 그쪽으로 옮길 만큼 충분히 낫지는 않을 뿐이죠.
시그모이드에 오신 걸 환영합니다...
어느 측면에서도 경쟁력이 없어 보이네요: https://artificialanalysis.ai/models/step-5#intelligence-comparisons
다음엔 더 잘 되길 바랍니다.
Artificial Analysis는 측정 대상에 대해 꽤 특정한 편향이나 관점이 있어서, 그쪽 벤치마크를 모델 품질의 결론으로 받아들이지는 않을 겁니다.
종합 지수가 유용한 건 N개의 용도에 쓸 수평적 역량 하나를 만들려는 모델 회사나, 모델과 용도를 신중하게 짝지어 보는 수고를 들이고 싶지 않은 초보 사용자뿐입니다. 파워 유저로서 이해하고 의도적으로 선택하려는 사람에게 필요한 건 종합 지수가 아니라 핀포인트 평가입니다. 세금 신고와 잔디 깎기를 같은 사람에게 맡기지는 않잖아요. LLM이라고 뭐가 다를까요? "AGI"를 둘러싼 속설을 가지고 문제에 접근해야 종합 벤치마크를 만들게 되는 겁니다.
다른 댓글에서도 말했듯이, Stepfun은 3.5/3.7 시절[1]에 작고 빠른 모델을 내놨는데, 지식은 일부러 포기하고 도구 호출 관리나 서브 에이전트 조율 같은 "범용 지능"에 집중했습니다. 개인 비서를 돌리는 기반으로 아주 좋을 수 있어요(어떤 접근이 맞는지는 시간이 말해 주겠죠). 그래서 그때 이후로 얼마나 발전했는지 직접 써 보고 싶습니다.
[1] https://news.ycombinator.com/item?id=47069179
어떤 모델이 특정 분야에서 더 낫지 않을까 늘 궁금했습니다. 저는 소프트웨어, 전기·기계 공학, 그 밖의 여러 일에 모델을 쓰거든요. 주제별로 눈에 띄는 차이를 느끼신 게 있나요?
빠릅니다. OpenRouter 기준 평균 속도가 초당 115토큰이에요. 실제로 써 보진 않아서 체감이 어떤지는 모르지만, 저라면 추론이 빨라지는 대가로 돈을 좀 더 낼 의향이 분명히 있습니다.
수정: 다만 평균 지연 시간이 1.5초라 아주 낮은 편은 아니어서, 에이전트 작업에서는 실제로 그렇게 빠르지 않을 수도 있습니다. 그리고 생각을 얼마나 하는지도 모르겠네요. 중국 모델은 보통 그게 약점이었으니까요.