요약
AlphaNIST는 성공·실패만 알려 주는 보상으로 로봇에게 정밀 조립을 시뮬레이션에서 익히게 했습니다.
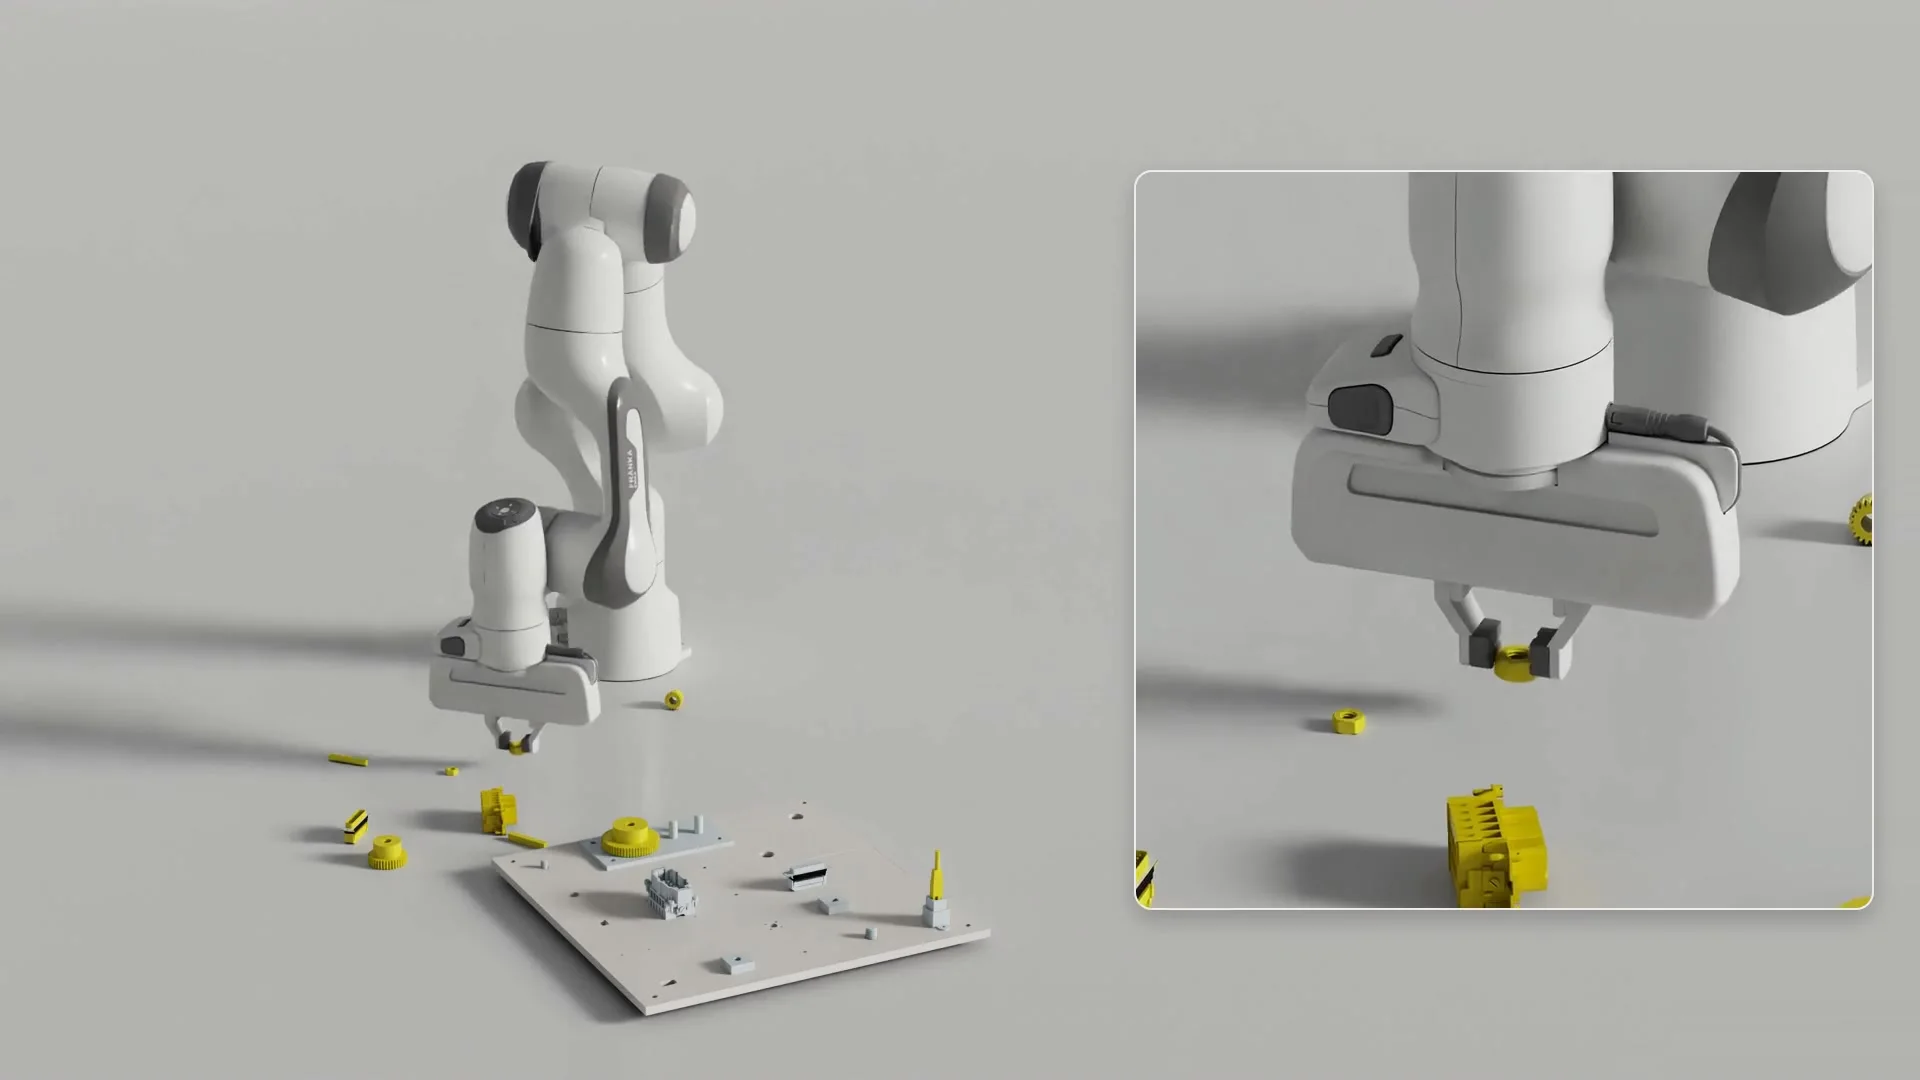
옥티 장과 야시라지 나랑 등 15명이 쓴 로봇 조립 논문의 소개 페이지입니다. HN 이용자에 따르면 엔비디아와 워싱턴대학교 연구진입니다. AlphaGo·AlphaZero처럼 사람의 시범 없이 대량의 경험으로 배우는 강화학습을 부품을 끼우고 조이는 조립 작업에 적용했습니다.
왜 중요한가
- 조립 단계를 사람이 나눠 주지 않아도 로봇이 다시 쥐기, 판에 대고 돌리기 같은 요령을 스스로 찾았습니다.
- 보상을 잘게 설계할 필요가 줄어듭니다. 오히려 단계별 보상을 더하면 성공률이 떨어졌습니다.
- 다만 저자에 따르면 이 논문에는 실제 로봇 실험이 없어, 현실에서도 통할지는 아직 확인되지 않았습니다.
핵심 내용
- 과제는 미국 국립표준기술연구소(NIST)의 조립 과제판 1번으로, 4mm짜리 부품을 포함한 20가지 조립이 들어 있습니다.
- 정책(로봇의 행동 규칙) 하나로 20가지를 함께 익혀 학습 성공률 98.2%를 냈고, 과제별 정책 20개(81.4%)보다 높았습니다.
- 같은 공유 정책에 다가가기·맞추기 단계 보상을 더하자 성공률이 17.8%로 크게 떨어졌습니다.
- 학습은 낱개 부품, 쥔 상태, 일부 조립된 상태 등 여러 시작점에서 출발하며, 절반쯤 성공하는 시작점을 더 자주 고릅니다.
- 너트를 손가락 끝으로 톡톡 쳐서 볼트에 돌려 넣는 동작처럼 설계자가 가르치지 않은 행동이 나타났습니다.
HN 반응
- 딥마인드와 무관한 연구에 'Alpha'를 붙여 구글 연구처럼 보이게 했다는 비판이 나왔고, 저자는 AlphaGo에 대한 오마주였다고 답했습니다.
- 실제 로봇으로 수십만 번 연습하긴 어렵다는 지적에, 저자는 시뮬레이션에서 배운 정책을 옮겨 쓰며 CAD 수준의 정밀한 부품 모델이 필수라고 답했습니다.
안녕하세요, 저자 중 한 명입니다!
질문 있으시면 답해 드리겠습니다! 그리고 "AlphaNIST"라는 이름은 2016년에서 2018년 무렵 딥마인드 데이비드 실버 연구팀이 내놓은 유명한 연구에 대한 오마주라는 점을 꼭 말씀드리고 싶습니다. 저희가 막 연구 경력을 쌓기 시작하던 때였고, 그분들의 연구가 저희에게 정말 큰 영향을 줬습니다.
물리적 제약을 다뤄야 하는 로보틱스처럼 까다로운 분야에서 그런 아이디어들이 통하게 만드는 데는 시간이 더 걸렸습니다(그리고 솔직히 이 논문에서는 실제 하드웨어로의 전이까지는 아직 보여 드리지 못했습니다). 하지만 지난 6개월 동안 매달려 온 다른 최근 논문에서 가능성이 보인다는 조짐을 어느 정도 확인했고, 이 논문은 CoRL에서 소개될 예정입니다: https://x.com/octi_zhang/status/2108583315544682914
저희 모두 여기서는 눈팅만 하던 헤비 롬러들이라, 1면에 오르게 되어 영광입니다!
혹시 몰라서 말씀드리는데, "alpha"는 딥마인드가 인수된 뒤의 "alphabet", 즉 구글을 가리키는 말이에요. 이 논문을 구글에서 나온 논문처럼 보이게 이름 붙이신 거죠.
말씀 잘 받았습니다! 저희도 같은 철학을 따르면서 접촉이 많은 로봇 제어 환경까지 고려했는데, 같은 오마주를 표하려면 어떤 이름이 더 나을지 고민해 보겠습니다.
논문에 감사의 말을 넣는 건 어떨까요? 다만 노력 없이 얻은 홍보를 위해 그쪽 작명 방식을 끌어다 쓰는 건 멋진 일이 아니에요.
정말 멋진 연구입니다. 창발적 행동이 너무 흥미롭고, NIST 표준 과제를 푼 것도 아주 인상적이에요! 적어도 산업용 조립 작업에서는 로봇의 손재주에 꼭 손이 필요한 건 아니라는 걸 보여 주네요. AlphaNIST를 보기 전에 CoRL 논문을 먼저 접했습니다. 실제 로봇으로 전이하려면 시뮬레이션 에셋 제작과 시스템 식별(sysID)·튜닝이 얼마나 필요했는지 궁금합니다.
따뜻한 말씀 감사합니다!
에셋을 "CAD 수준으로 정확하게" 만드는 것이 실제로 이게 작동하게 하는 데 엄청나게 중요합니다. 협력자인 Yash Narang [1]과 Iretiayo Akinola [2]가 몇 년 동안 바로 이 일에만 매달려 왔을 정도예요. 저희는 거인의 어깨 위에 서 있는 셈입니다!
또 모터와 컨트롤러 동역학을 비롯해 하드웨어를 깊이 이해하는 것도 타협할 수 없는 부분입니다. 공짜 점심은 정말로 없다는 걸 힘들게 배웠습니다. 물리학과 공학을 제대로, 깊이 이해해야 합니다.
[1] https://scholar.google.com/citations?user=M3NuG7AAAAAJ&hl=en [2] https://scholar.google.com/citations?user=e1zesfMAAAAJ&hl=en
엔비디아와 워싱턴대 연구진이 쓴 로보틱스 논문입니다.
Alphabet/딥마인드 논문도 아니고, "NIST" OCR 데이터셋과도 아무 관련이 없고요.
"AlphaNIST"보다 더 적절한 이름이 정말 없었나요?
NIST 보드 챌린지예요. https://www.nist.gov/el/intelligent-systems-division-73500/robotic-grasping-and-manipulation-assembly/assembly
저는 미국 국립표준기술연구소(National Institute of Standards and Technology)를 떠올렸어요... "STL"처럼 약어와 이름이 겹치는 경우가 참 많네요!
우와, 딥마인드가 미국 국립표준기술연구소를 풀어 버렸다고요???
이전 상황: 경쟁하는 표준이 14개 있다.
곧 닥칠 상황: 가능한 모든 상황에 맞춘 표준이 15조 개 있다.
로봇이 너트를 조이는 방식이 너무 웃기네요. 현실에서는 절대 안 통할 거예요 :)
(그래도 이 연구 전체가 정말 멋집니다. 다만 실제 로봇에 잘 옮겨지려면 필요한 롤아웃 횟수부터 줄여야 할 것 같아요. 작은 부품을 가지고 실제 롤아웃을 수십만 번 돌리면, 바닥에 떨어진 부품을 치우고 학습하는 동안 로봇이 물리적으로 부수는 모든 것을 감당하는 일이 정말 골치 아픈 물류 문제가 될 테니까요.)
저희는 증류 기반 전이를 쓰는 sim2real 방식을 사용합니다 :)
그래서 먼저 실제 로봇으로 롤아웃을 할 필요가 없어요! 전이 사례는 https://sgs-rl.github.io 에서 확인해 보세요(AlphaNIST에서 다룬 여러 부품의 NIST 보드보다는 단순한 환경이긴 합니다).
정말 멋진 작업이에요. 특히 튕기는 동작이 마음에 들었는데, 움직임이 아주 유기적이에요.
저와 같은 의문을 가진 분이 있을지 몰라 말씀드리면, 로봇은 포인트 클라우드를 입력으로 "보는데", 속도를 뺀 시뮬레이션 상태 전체를 사실상 그대로 받는 셈입니다(틀렸다면 정정해 주세요). 한계 부분에도 적혀 있듯이 "인식 오차, 지연, 접촉 모델 불일치에 대한 견고성은 [확인하지] 않았습니다".
로봇 그리퍼 팔의 움직임과, 긴 물체를 다루는 모습("단일 부품 조립 실험", 1:00부터)이 왠지 말이 머리를 움직이는 모습을 떠올리게 해요.
링크는 안 누르고 물어봅니다. 이게 뭔가요? 짧게 설명해 주시면 안 될까요?
Alphanist - 뭔가를 하는 앱/라이브러리/코드
엔비디아와 워싱턴대 논문의 부속 블로그 글입니다. 학습 기반으로 정밀도 높은 로보틱스 작업을 푸는 접근법을 다루고 있어요.
HN 가이드라인은 블로그 글의 제목을 그대로 쓰고 편집하지 말라고 하고 있고요.
HN 가이드라인이 글을 올린 사람이 설명하는 첫 댓글을 다는 것까지 막는 건 아니에요.
맞는 말씀이에요. 제가 그렇게 했어야 했네요.
시작 상태를 작업의 서로 다른 지점에 두는 것과, 성공을 기준으로 시작 상태를 샘플링하는 것은 정말 훌륭한 아이디어 같습니다. 제가 한동안 RL을 따라가지 못했는데, 이게 얼마나 새로운 건가요?
이 메커니즘은 커리큘럼 학습과 느슨하게 관련이 있지만, 저희는 몇 가지 차이가 있다고 주장합니다. 방법론을 다룬 부속 논문( https://sgs-rl.github.io )의 관련 연구와 베이스라인 부분에서 PLR(이것도 딥마인드 작업입니다), SFL, 상태에 대한 선형 수작업 커리큘럼 같은 방법과 비교한 내용을 더 자세히 다뤘습니다.
그런데 덕분에 영감이 떠올랐어요. 관련 기법들을 더 낮은 차원의 환경에서 설명하면 개념을 더 효과적으로 가르칠 수 있겠네요! 금방 돌아올게요!