요약
임베딩 모델 EmbeddingGemma 2에 작은 판독기를 붙여 맥에서 빠르게 도는 음성 인식기를 만들었습니다.
구글 딥마인드의 EmbeddingGemma 2는 글, 이미지, 음성, 영상을 한 벡터 공간(뜻이 비슷하면 가까이 놓이는 수치 공간)에 담습니다. 개발자 샤히르는 말소리가 그 단어의 글자 근처에 놓인다는 점을 이용해 단어를 바로 읽어 낼 수 있는지 실험했습니다.
왜 중요한가
- 음성 인식용으로 학습한 적 없는 임베딩 모델도 작은 판독기만 학습하면 받아쓰기에 쓸 수 있음을 보였습니다.
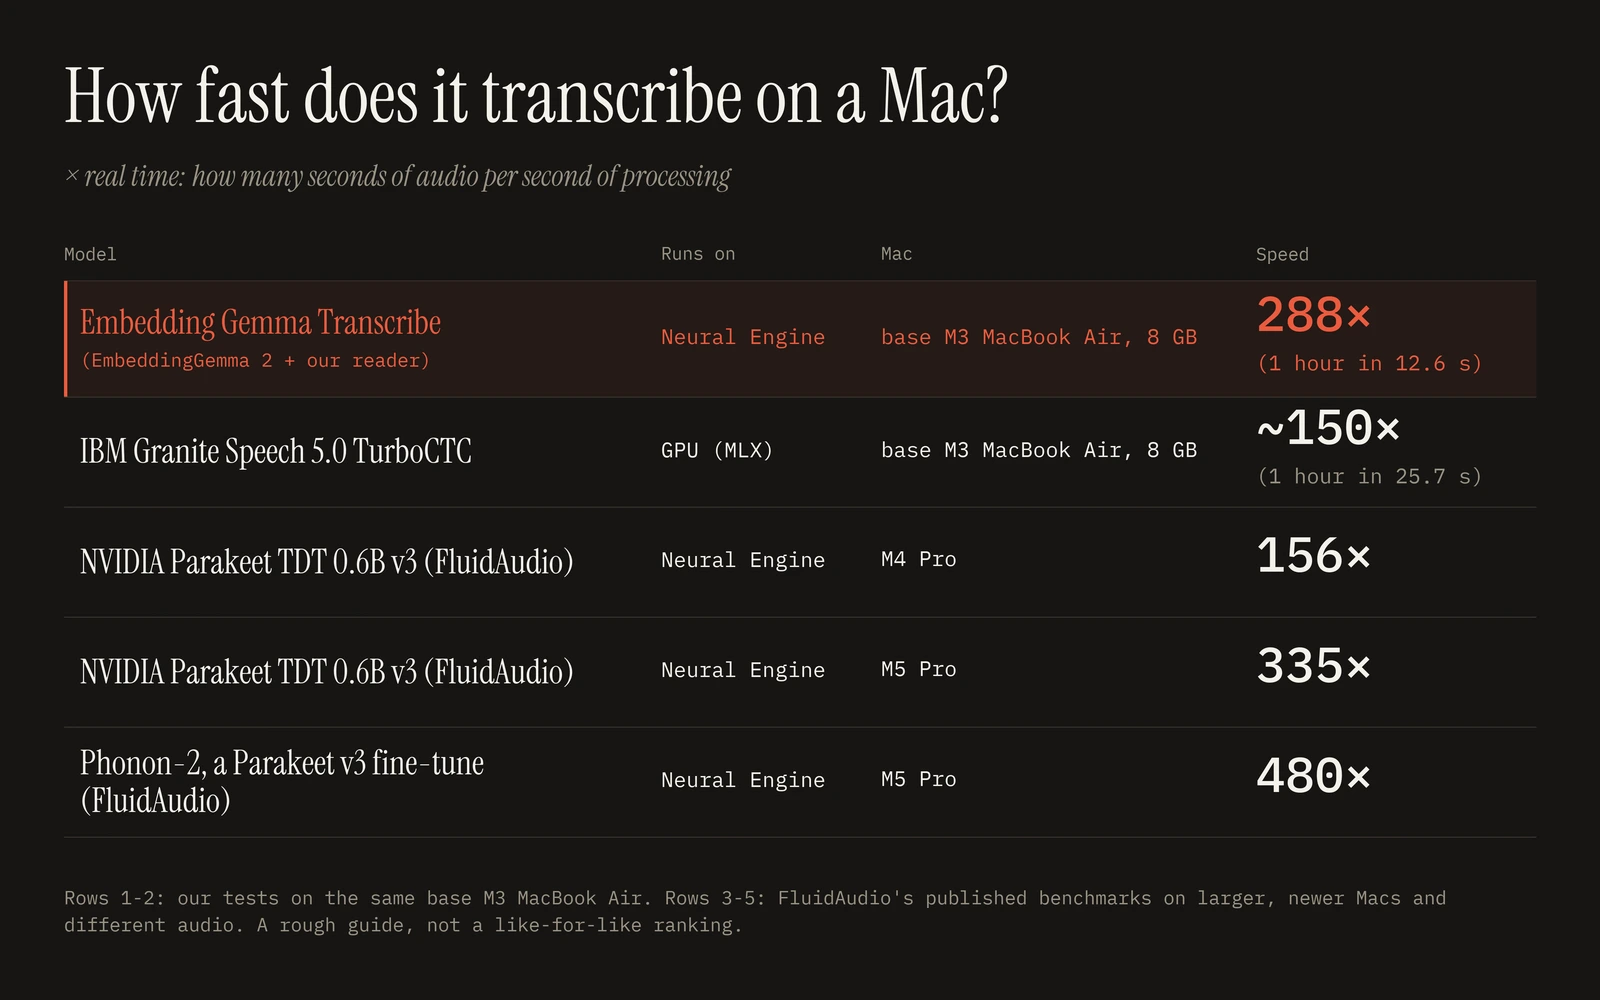
- 기본형 M3 맥북 에어(8GB)에서 1시간 음성을 12.6초에 처리해, 같은 기기에서 잰 IBM Granite Speech 5.0 Turbo보다 2배쯤 빨랐습니다.
핵심 내용
- 원래 모델의 오디오 인코더는 그대로 두고, 짧은 음성 조각을 텍스트 공간으로 옮기는 판독기만 새로 학습했습니다.
- 조각마다 영어 단어 약 22만 9천 개 가운데 가장 가까운 단어를 고르고, 별도의 작은 모델이 문장부호와 대소문자를 붙입니다.
- 판독기 학습에는 공개 라이선스 영어 음성만 썼고, H100 GPU 8장으로 2시간이 채 걸리지 않았습니다.
- 단어 오류율(WER, 잘못 받아쓴 단어의 비율)은 약 5%로 선두 모델의 2~3%보다 높아, 판독기 개선을 다음 과제로 꼽았습니다.
- 맥용 무료 앱으로 나왔고, 애플 Neural Engine에서 돌아 음성이 기기 밖으로 나가지 않는다고 밝혔습니다.
HN 반응
- 페이지의 Apache 2.0 표기는 앱이 아니라 기반 모델의 라이선스라는 지적이 나오자, 개발자는 며칠짜리 실험이라며 곧 오픈소스로 공개하겠다고 답했습니다.
- 직접 재 본 이용자들은 이미 빠른 Parakeet v3와 비슷한 속도라고 전했고, WER 5%가 어떤 벤치마크 기준인지 묻는 질문도 나왔습니다.
안녕하세요, 저는 샤히르입니다. 이건 제가 한 실험이었습니다. 우선 HN에 올려 주신 분께 감사드립니다. 전혀 예상하지 못했습니다.
분명히 해 두자면, 이 프로젝트는 Embedding Gemma 2에서 텍스트와 오디오가 같은 벡터 공간을 공유한다는 점을 이용해 오디오를 텍스트로 바꿀 수 있는지 보려는 실험으로 시작했습니다. 몇 군데 우회해야 했지만 결국 됐습니다. 속도는 덤으로 따라온 이점일 뿐, 노린 것은 아니었습니다.
정확도는 괜찮은 편이지만 클라우드 모델 수준은 아닙니다. 그래도 일상에서 쓰기엔 충분하고, 이건 고작 며칠 작업한 결과입니다. 다양한 데이터로 더 학습시키면 WER은 크게 좋아질 수 있습니다. 다음에는 그걸 해 볼 생각입니다.
전체를 곧 오픈소스로 공개하겠습니다. 며칠은 걸릴 수 있습니다. 이 모델의 TTS 버전도 곧 내놓을 예정입니다.
궁금한 점이 있으면 편하게 물어보세요.
어제 올리신 글 덕분에 granite-speech-5.0-470m-turboctc를 알게 됐어요. 이미 충분히 빨라서 비교 대상으로 쓰신 거겠죠.
감사합니다!
(지금까지는 mlx-community/parakeet-tdt-0.6b-v3를 써 왔거든요.)
네, Granite는 정말 빠릅니다. IBM이 사람들 눈에 잘 띄지 않는 곳에서 훌륭한 모델을 꽤 많이 내놓고 있습니다.
재미있는 실험이네요. 속도는 더 빠르면서 WER까지 최고의 오픈 웨이트 모델과 맞먹는다면 정말 대단할 거예요.
EmbeddingGemma 2와 Gemma 4가 얼마나 훌륭한지 사람들이 충분히 주목하지 않는 것 같아요.
더 다양한 오디오로 리더를 실험해 보고 있습니다. 어쩌면 초고속 후처리 레이어도 붙여 볼 생각입니다.
이 도구로 라틴어 텍스트도 받아 적을 수 있나요? McWhisper는 된다고들 하는데, 막상 돌려 보면 엉터리가 나오더라고요.
오, 라틴어 좋죠! 프로젝트 공유해 주실 수 있나요?
아주 빠른 모델에 관심 있는 분들께 알려 드립니다.
이런 모델을 macOS에서 아주 빠르게 돌릴 때 제가 즐겨 쓰는 "신박한 요령"은 CoreML로 변환해서 Neural Engine에서 돌리는 것입니다.
Spleeter, Demucs, MVSEP-MDX23-music-separation, DeepFilterNet, Whisper, 3D 메시 생성용 Hunyuan3D로 놀라운 성과를 봤습니다. 업무용이든 취미용이든 다른 모델도 많이 그렇게 돌렸습니다.
코드도 의존성 없는 Swift로 옮기는데, 이건 어디까지나 제 취향입니다.
일부 모델은 실행 시간이 60초에서 10초로 줄기도 했습니다. 게다가 그냥 Swift라서 개발자가 아닌 동료에게 건네줘도 파이썬 환경을 통째로 설치할 필요가 없습니다.
직접 하기 귀찮다면, 요즘 LLM이 이런 작업을 잘합니다. Luna도 별 어려움 없이 해냅니다.
코로나 시기가 뒤섞여서 그렇게 느끼는 걸 수도 있지만, "자동 음성 받아쓰기는 켜 둘 가치도 없다"던 시절에서 "한 시간 분량의 오디오를 로컬에서 13초 만에 받아 적는" 시대가 이렇게 빨리 왔다는 게 지금도 믿기지 않아요.
팬데믹 전에는 최고 수준이라는 자동 받아쓰기 기능조차 쓸 수 없을 만큼 형편없어 보였거든요. 그게 벌써 7년쯤 전 일이긴 하네요.
누가 유튜브 팀에 이 얘기 좀 전해 줬으면 좋겠네요. 앞으로 10년쯤 지나면 거기서도 이런 게 있다는 걸 알아차리겠죠.
무슨 말씀인지 모르겠네요. 몇 년 전에 자동 자막을 추가했는데 놀라울 정도예요. 저는 6~8시간짜리 법정 영상에 자주 쓰는데, 제가 써 본 다른 로컬 솔루션보다 낫습니다. 물론 완벽하진 않지만요.
최근에 오래된 M1 맥북 에어에서 MacWhisper로 Parakeet v3를 쓰기 시작했습니다. 너무 빨라서 실패한 줄 알았습니다. "받아쓰기"를 누르고 몇 초 뒤에 화면을 다시 봤더니 이미 변환이 끝나 있었으니까요. 정말 말도 안 되게 빠릅니다.
다들 "오래된 M1 맥북 에어"라고 하지만, 그 아키텍처는 워낙 획기적이라 2026년인 지금도 현역입니다. 애플이 2020년에 출시할 때 그 가치를 너무 낮춰 말한 게 분명해요.
제 더 강력한 컴퓨터에서 애플의 온디바이스 받아쓰기 모델은 애플이 발표한 결과보다 약 3배 느렸고, 제 테스트에서 오류율은 비슷했습니다(꽤 좋은 결과라고 봅니다).
이 모델도 시간이 나면 테스트해 보겠습니다.
애플 모델을 감싸 간단한 벤치마크를 제공하는 샘플 CLI입니다: https://github.com/llimllib/transcribe
추가: 모델 자체는 제공하지 않는 것 같고, 앱 번들에서 파내고 싶지도 않아서 이건 테스트하지 않기로 했습니다.
애플 걸 쓸 가치가 있기는 한가요? 개선됐을지도 모르지만, 음성 메모 받아쓰기에 처음 도입했을 때는 (제 경험으로는) 웃길 정도로 형편없었어요. 저는 그냥 whisper.cpp를 쓰고 있습니다.
저는 Handy에 Deepgram API 서버를 억지로 붙이기 전까지 제 AI 클라이언트에서 그걸 많이 썼습니다. 받아쓰기 한 건 한 건마다 믿을 수 있을까 걱정하느라 머리가 아플 만큼 별로였어요.
애플 인텔리전스가 켜지는 최신 기기에서는 개선됐다고 하던데, 저는 그런 기기가 없습니다.
참고로 제 테스트는 이전 모델이 아니라 Apple Intelligence 모델을 대상으로 한 겁니다.
애플 건 whisper.cpp의
large-v3-turbo보다 5배 빠르지만 제 테스트에서는 성능이 다소 떨어졌습니다. 그러니 일장일단이 있는 셈입니다.애플의 강점은 다국어 지원일 것 같습니다.
저는 제 앱에서 애플의 온디바이스 번역을 쓰는데, 꽤 잘 작동합니다. 문맥을 고려하는 ChatGPT 번역이 더 낫긴 한데, 그건 온디바이스가 아니니까요.
MacWhisper에서는 애플 모델을 고를 수 있는데, 같은 파일을 받아쓰는 데 이 소프트웨어나 MacWhisper/Parakeet3보다 거의 4배나 오래 걸렸습니다.
흥미롭네요! 저는 제 에이전트가 영어 받아쓰기엔 v2가 더 빠를 거라고 해서 Parakeet v2만 테스트했거든요(v3는 다국어를 지원하지만 조금 더 느리다고 했습니다).
제 벤치마크에서는 parakeet-tdt-0.6b-v2가 2배 느립니다.
그 앱을 거치면 다른 애플 모델을 쓰는 건 아닐까 싶네요. 잘은 모르겠지만요.
M4 맥 미니(램 24GB)에서 33분짜리 로컬 오디오 파일로 테스트했더니 이 소프트웨어로는 받아쓰는 데 6.75초가 걸렸습니다. MacWhisper/Parakeet3는 스톱워치로 재 보니 약 7.5초였습니다.
실험에 박수를 보냅니다. 잠재 공간이 모달리티 사이에서 공유된다는 점과 훌륭한 성능을 함께 보여 주는 좋은 사례네요.
WER 5%라고 하셨는데, 어떤 벤치마크 기준인가요?
예를 들어 Whistle [1]은 16MB짜리 STT 모델인데, 벤치마크에 따라 WER이 4~26%까지 오르내립니다.
[1] https://cactuscompute.com/blog/whistle
좋네요. Parakeet, 그리고 최근에 나온 Needle과의 비교도 보고 싶습니다. 받아쓰기 속도와 정확도에 대한 벤치마크가 있나요?
오픈소스인가요? Apache 라이선스를 언급하긴 하는데, GitHub 같은 링크는 찾을 수가 없네요.
EmbeddingGemma 2가 Apache 2라는 얘기만 보입니다.
"EmbeddingGemma 2는 Google DeepMind가 만들었고 Apache 2.0으로 공개되었습니다. 이 프로젝트는 독립 프로젝트이며 Google과 제휴하거나 Google의 보증을 받은 것이 아닙니다."
페이지에 나온 Apache 2.0은 이 앱이 아니라 구글의 기반 모델을 가리킵니다. 페이지만 보면 앱은 무료이지만 소스 코드는 오픈소스가 아닙니다.
https://huggingface.co/google/embeddinggemma-2
다운로드한 모델은 다음 위치에 저장됩니다.
흥미로운 접근이네요. 그렇다면 단어를 제가 실제로 쓰는 것들로만 제한해서, 대화의 99%에서 제가 쓰는 단어하고만 가장 가까운 것을 찾는 아주 작은 모델을 만들 수 있다는 뜻인가요?