요약
이미 학습된 언어 모델을 적은 추가 학습만으로 바이트 단위 모델로 바꾸는 방법이 나왔습니다.
벤저민 미닉스호퍼, 루크 제틀모이어 등 연구진이 네이처에 발표한 논문입니다. 대부분의 언어 모델은 단어 조각(서브워드) 단위로 글을 읽기 때문에, 글자 하나가 뜻을 좌우하는 코드나 생물 서열을 잘 다루지 못한다는 문제에서 출발했습니다.
왜 중요한가
- 연구진은 바이트 모델이 뒤처진 원인을 처음부터 새로 학습하는 방식에서 찾았고, 잘 만든 기존 모델을 고쳐 쓰는 길을 제시했습니다.
- 원본 모델의 지시 따르기 학습 결과를 추가 학습 없이 옮길 수 있어서, 바이트 모델 연구의 실험 주기가 짧아질 수 있습니다.
- 연구진은 바이트 모델이 영어 중심 토큰화의 편향을 줄이고, 에너지와 배포 비용도 낮출 수 있다고 봤습니다.
핵심 내용
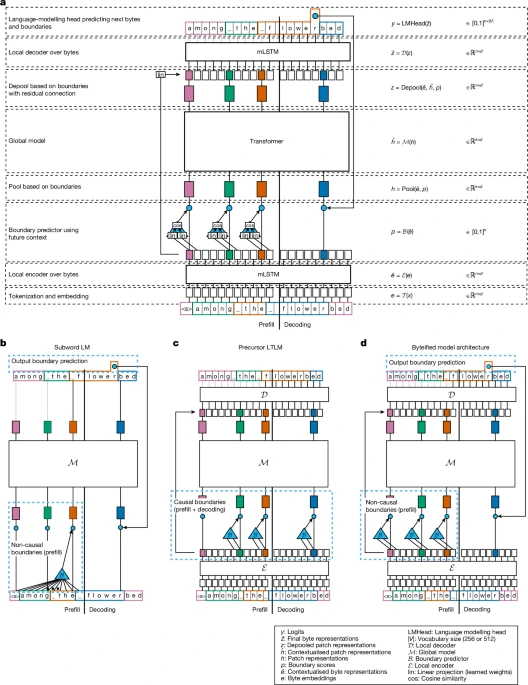
- Olmo 3 7B, Qwen3 8B, Llama 3 8B를 491억 토큰(일반 사전 학습 예산의 1% 미만)만 더 학습시켜 바이트 모델로 바꿨습니다.
- 바꾼 모델들은 원본 성능에 근접했고, 글자 단위 이해에서는 원본을 크게 앞섰습니다.
- Olmo 3를 바꾼 Bolmo 7B는 처음부터 학습한 바이트 모델 BLT 7B보다 STEM 과제 점수가 16.5%포인트 높았습니다.
- 바이트를 묶음(패치)으로 나눌 때 다음 바이트 하나를 미리 보는데, 서브워드 토크나이저도 뒤 글자를 보고 토큰을 끊는다는 점에 착안했습니다.
- 묶음을 크게 잡도록 학습하면 속도를 더 올릴 수 있었고, 어휘가 일정 크기를 넘으면 서브워드 모델보다 효율이 앞섰습니다.
HN 반응
- 기존 모델에도 바이트 토큰이 있다는 지적에, 바이트 토큰만 써야 글자 수 세기 같은 토큰화 실패를 피한다는 반박이 나왔습니다.
- 네이처가 학회에 낼 만한 평범한 머신러닝 논문을 실었다는 비판이 나왔고, BLT·H-Net 같은 앞선 연구를 짚는 댓글도 이어졌습니다.
글이 너무 길어서 원문의 앞부분만 보고 정리했습니다.
토큰 없는 LLM은 이미 연구가 많이 이뤄졌습니다. 그런데도 우리가 여전히 토큰 방식으로 일하고 있다면, 거기에는 그만한 이유가 있다는 뜻이겠죠.
Byte Latent Transformers(BLT): https://arxiv.org/abs/2412.09871
Charformer: https://arxiv.org/abs/2106.12672
사람의 뇌도 하는 "청킹(chunking)" 때문입니다. 입도를 잘게 쪼갤수록 경우의 수가 늘어나고, 기존 시스템과 같은 성능을 내는 데 필요한 연산량도 커집니다.
예를 들어 GPT4의 토크나이저는 코드 구조를 위한 확장 토큰을 썼고, 코드를 충분히 학습시킨 덕에 한동안 다른 모델보다 한참 앞서 있었습니다.
토크나이저와 그 어휘집이 성능에 큰 차이를 만듭니다.
반복적인 청킹이야말로 트랜스포머의 핵심 아닌가요? 아니면 바이트 수준에서 하면 오버헤드가 그렇게 커지나요?
반복적 청킹이 무슨 뜻입니까? 바이트에서 시작해 토큰이나 단어 수준의 표현을 계층적으로 쌓고, 디코딩할 때는 그 과정을 거꾸로 되돌리는 트랜스포머 변형들이 있기는 합니다. 하지만 제대로 자리 잡은 적은 없습니다. 좋은 토크나이저와 비교해 별 도움이 되지 않았거든요.
아닙니다. 대부분의 트랜스포머 변형은 평평한 스트림이나 고정 크기의 내부 상태 위에서 동작합니다.
확산 모델은 토큰이 없는 것 아닌가요?
아니요, 여전히 토큰 위에서 동작합니다. 텍스트를 샘플링하는 방식이 다를 뿐이에요. 여러 토큰 위치에 걸쳐 반복적으로 노이즈를 제거하는 방식으로, 그걸 병렬로 처리합니다.
H-Net: https://proceedings.iclr.cc/paper_files/paper/2026/hash/f1aa53cac69ef6980ca4a911ffcf278b-Abstract-Conference.html
서브워드 토크나이저는 애초에 인과적(causal)이지 않았으니, BPE는 줄곧 뒤에 올 바이트를 미리 훔쳐보고 있었던 거네요! 오늘도 하나 배웠습니다
이게 BPE 토큰화와 뭐가 다른지 모르겠습니다.
와, 네이처가 제대로 낚였네요. 자기네 전문 분야 근처에 머물렀어야 했는데요. 이미 응용 AI 논문을 이것저것 받아 주다가 호구 잡히고 있었잖아요.
이 논문의 어디가 문제인가요?
뻔한 연구인데 최신 기술 수준에는 못 미칩니다. 분야를 정의할 만한 연구도 아닙니다. NeurIPS나 ICML에 내기에는 무난한 논문이지만, 그중에서도 딱 중간 정도입니다.
네이처에 실리는 논문이라면 그해 해당 분야에서 최상위권 성과여야 합니다. 이 논문은 그냥 무난한 수준일 뿐입니다.
덧붙여 설명하면, 네이처는 역사적으로 순수 머신러닝 논문을 싣는 곳이 아니었습니다. 물리과학 분야에서 판도를 바꾸는 연구를 싣던 곳이죠. 머신 인텔리전스 자매지도 이미 따로 있고요.
이 논문을 보니 네이처가 ML 논문에 얼마나 목말라 있는지, 그리고 직원들이 이 분야를 얼마나 이해하지 못하는지 알겠습니다.
어차피 네이처는 요즘 과학 분야에서 선정적이고 과장됐거나 아예 틀린 것들을 싣는다는 평판이 좀 있잖아요... 그러니 ML 논문에 목말라 있다고 해도 하나도 놀랍지 않아요 :-I
20년 전에 네이처 논문을 수십 편 낸 교수님이 저한테 그러셨어요. 네이처는 결국 그림 하나 예쁘게 뽑는 게 전부라고요.
이상한 논문이네요. 모델에는 이미 오래전부터 바이트마다 토큰이 있었습니다. 여러 바이트로 이뤄진 토큰과 함께, 개별 바이트도 아무 문제 없이 읽고 쓸 수 있어요.
요점은 바이트 토큰을 갖는 게 아니라 바이트 토큰만 쓰는 겁니다. 그러면 토큰화 때문에 생기는 흔한 실패(예를 들어 strawberry에 R이 몇 개 있는지 세는 문제)를 피할 수 있으니까요.
바이트 토큰이면 R 개수 문제가 정말 풀릴까요? 처리 중인 토큰을 스스로 들여다보는 수준의 인식이 있어야 할 것 같은데, 트랜스포머에는 그런 게 없다고 생각해서요. 다만 그 직관 너머를 논할 만큼 전문가는 아니라서 틀렸을 수도 있습니다.
모델은 대체로 숫자를 셀 수 있습니다.
물론 그렇죠. 하지만 바이트 단위 토큰이 아니어도 바이트를 셀 수는 있을 겁니다.
모델이 자기에게 입력된 토큰을 들여다볼 수 있나요?
LLM이 받는 게 토큰화된 것뿐이라면 개별 바이트를 어떻게 읽을 수 있죠? 아니면 토큰화하는 법을 몰랐던 것들만 따로 받는 건가요?
이런 식으로 계속됩니다.
토크나이저가 원래 다른 토큰으로 쪼갤 수 있었던 부분도 개별 바이트 단위로 읽도록 전환할 줄 알아야 하겠지만, 그건 무엇보다 라벨링의 문제로 보입니다.
토크나이저에 다 적혀 있어요. 수만, 수십만 개의 토큰 중 256개가 각각 한 바이트에 대응합니다. 그게 끝이에요.