요약
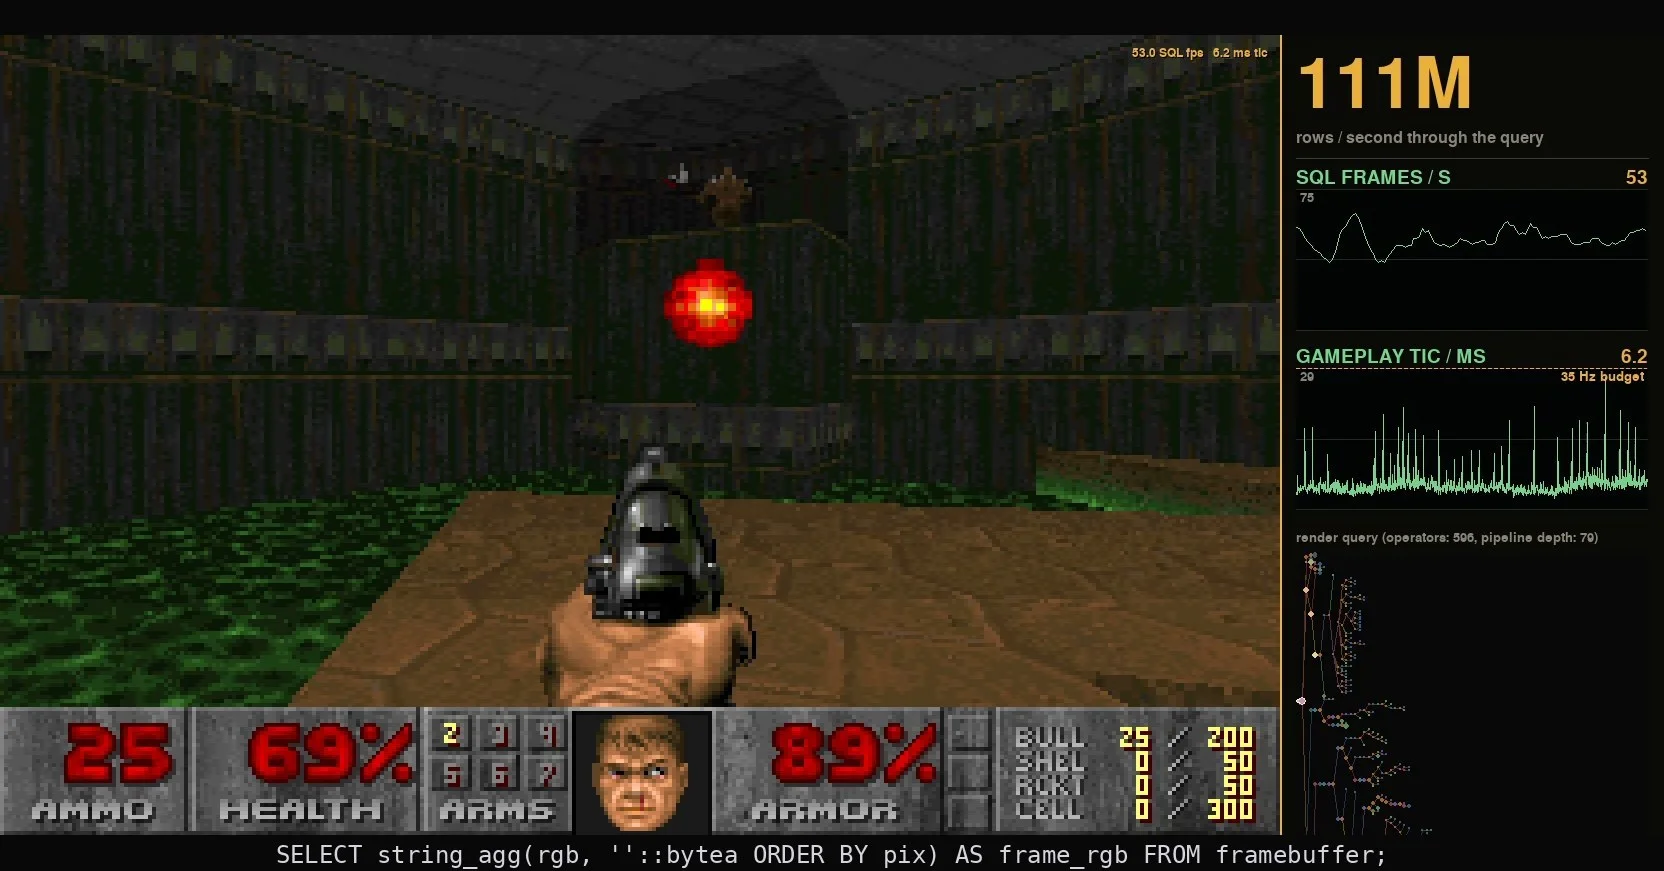
시더DB 개발자가 1993년판 Doom의 게임 로직과 화면 렌더링을 SQL로 옮겨 데이터베이스 안에서 돌렸습니다.
데이터베이스 회사 시더DB의 루카스 포겔이 쓴 글입니다. 그는 지난해 광선 투사(레이캐스팅) 방식의 DOOMQL을 만들었습니다. 이번에는 원작처럼 BSP 트리(공간을 나눠 그릴 순서를 정하는 자료구조)로 그리는 방식까지 SQL로 구현했습니다.
왜 중요한가
- 복잡한 게임 규칙도 SQL로 원작 C 코드보다 짧게 표현할 수 있다는 사례입니다.
- 무기 성능과 애니메이션 상태가 모두 테이블의 행이라 게임을 다시 시작하지 않고 바로 고칠 수 있습니다.
- 트랜잭션(여러 변경을 한 묶음으로 처리하는 단위) 덕분에 멀티플레이 동기화를 따로 만들 필요가 없었습니다.
핵심 내용
- 게임 로직은 SQL 약 5,900줄로, 같은 일을 하는 원작 C 코드(약 9,000줄)보다 짧습니다.
- 게임 루프는 원작과 같은 초당 35틱으로 돌고, 렌더러는 노트북에서 320x200 화면을 최대 60Hz로 만듭니다.
- 매 틱을 트랜잭션 하나로 묶어, 최대 4명이 하는 데스매치에서도 모두가 일관된 상태를 봅니다.
- Python은 시간 맞추기, 키보드 입력, 화면 표시만 맡고 나머지는 모두 데이터베이스가 처리합니다.
- 글쓴이는 데이터베이스로 렌더링하는 것은 명백히 나쁜 생각이라며 486 컴퓨터에서 성능을 짜낸 존 카맥의 설계를 높이 샀습니다.
HN 반응
- 업무 로직을 데이터베이스 안에 두는 방식을 두고, 반도체 공장 운영을 SQL로 했다는 경험담 등 지지 의견이 나왔습니다.
- 반면 저장 프로시저(데이터베이스에 저장해 두는 함수)는 디버깅과 버전 관리가 괴롭고 SQL에 능숙한 사람이 드물다는 반론도 많았습니다.
저는 요즘 SQL이 할 수 있는 일을 HN이 크게 간과하고 있다고 봅니다.
어떤 업종은 너무 복잡해서 그 도메인을 절차적 코드로 유지보수하기가 사실상 불가능합니다. 비즈니스 규칙을 SQL로 구현하면 문제를 쪼갤 수 있고, 그만큼 훨씬 많은 사람이 동시에 그 문제에 참여할 수 있습니다.
반도체 제조업에서 일할 때 우리는 공장을 돌리는 데 저장 프로시저와 SQL에 크게 의존했습니다. 운영상의 의사결정 로직이 코드에 있는 경우는 거의 없었습니다. 수백 명의 사용자가 같은 프로시저 묶음을 들여다보고 수정을 제안했습니다. 테스트도 간단했습니다. 매일 아침 운영 DB를 복제해서 실제 데이터를 놓고 바로 실험할 수 있었으니까요. 비즈니스의 정보와 그 로직 사이에 틈이 없었습니다. 대부분의 회사는 이렇게 운영하지 않습니다. 데이터베이스를 데이터와 로직이 만나는 중심으로 쓰지 않고, 그저 CRUD 조회 엔진 정도로 취급합니다.
마이크로소프트, 오라클, IBM에 큰돈을 쓰자고 주장하는 사람들은 대개 위와 같은 것을 원하는 겁니다. 비즈니스가 그 안에서 돌아가는 시스템이 말 그대로 하나이기를 바라는 거죠. 하나로 해결할 수 있는데 솔루션을 10개 넘는 벤더와 도구에 흩어 놓는 건, 조직에서 맡은 역할에 따라서는 거의 직무유기에 가깝습니다.
SQL로 복잡한 로직을 짜는 것보다 하고 싶지 않은 일은 거의 없습니다. 요즘은 그래도 SpacetimeDB 함수라는 대안이 있죠 https://spacetimedb.com/docs/functions 하지만 mssql 같은 곳에서 문자열 위주(stringly typed)의 환경에, 표준 라이브러리도 거의 없는 채로 모든 걸 하라고요? 이게 인기 있는 패턴이 아닌 데는 이유가 있습니다.
현재 직장에서 저는 데이터 분석 플랫폼 개발을 맡고 있는데, 워낙 데이터 중심이라 로직의 95% 정도를 대부분 함수와 저장 프로시저로 데이터베이스에 직접 구현할 수 있었습니다. 나머지 5%의 애플리케이션 코드는 대부분 Python인데, HTTP 게이트웨이에서 그 함수들을 호출하고 결과를 XLSX 파일로 만들어 주는 연결 역할만 합니다. 거의 SQL만으로 이렇게 많은 걸 할 수 있다는 게 놀랍습니다(좀 더 절차적인 부분은 어쩔 수 없이 plpgsql을 써야 했지만, 예외적인 경우였습니다).
지금은 연산량이 큰 데이터 분석 작업 일부를 DuckDB로 바꾸는 중인데, 정말 멋진 경험입니다.
SQL이여 영원하라!
비즈니스 로직을 어느 계층에 둘 것인가는 늘 아주 흥미로운 아키텍처 문제입니다. SQL에 두는 게 맞는 이유가 분명히 있는 로직도 있지만, 저는 정말 까다로운 로직 중에서도 가장 복잡한 것은 SQL에 두지 않으려는 편입니다.
상황이 정말 꼬이거나 비즈니스 로직이 계속 발밑에서 바뀔 때는, DB에는 마지막 방어선이 될 제약 조건만 걸어 두고 로직 대부분은 애플리케이션 스택 어딘가에 둡니다.
지금까지 같이 일한 사람 중에 그 계층에서 복잡한 비즈니스 로직을 넘겨받아 쉽게 다룰 만큼 SQL을 잘 아는 사람은 한 손으로 꼽을 정도입니다. 지난 10년 동안은 주로 작은 회사에 있었는데, 큰 조직에는 그걸 맡을 수 있는 데이터 엔지니어가 더 많이 있겠죠.
2010년대에 2000년대 레거시 앱의 저장 프로시저를 디버깅하고 고치는 게 정말 싫었습니다. SP 코드는 일반 코드 취급을 받지 못했고, 소스 관리도 되지 않았어요. 비즈니스 로직을 전부 코드 안에 두지 않고 DB 안에 둔 탓에 대체로 안 좋은 기억만 남았습니다.
저도 저장 프로시저를 오래 다루면서 같은 기억이 있습니다. 다만 소스 관리는 당연히 했어야 하는 일이죠.
그래도 멀리 떨어진 엔지니어링 팀의 누군가가, 데이터베이스를 망가뜨렸을 데이터를 커밋하지 못해서 문제라고 신고해 올 때만큼 뿌듯한 순간은 없습니다. 참조 무결성 제약 조건이 데이터베이스를 지켜 준 덕분이니까요.
AI 시대에 데이터베이스를 건드리는 코드가 폭발적으로 늘어난 지금은, 로직과 제약 조건을 우회할 방법이 없는 데이터베이스 안에 넣는 게 오히려 더 합리적일지도 모릅니다.
저희도 이렇게 합니다. 물론 단점도 있지만 전반적으로 몇 년째 잘 굴러가고 있습니다. 그런데 저장 프로시저를 쓰는 게 문제라서 이 제품을 퇴역시켜야 한다는 말을 들었다는 게 웃깁니다. 그 대체품의 의존성 그래프를 한번 보셔야 해요.
로직을 데이터베이스에 저장하고 계실 수는 있지만, 대부분의 회사는 데이터베이스에 데이터를 저장하고, 그 양이 (대부분 뭐가 중요하고 뭐가 아닌지 구분하지 못하기 때문에) 너무 많아서 매일 아침 데이터베이스를 통째로 복사하는 건 꽤 비현실적이에요.
일부 대형 통신사는 그렇게 하고 있어요. 데이터베이스를 매일 복제하는 게 왜 문제가 되죠?
시스템을 설계할 때 그걸 고려하지 않았기 때문이겠죠. 당연히 문제가 되지 않아야 하지만, 지금 우리가 얘기하는 건 형편없는 기술적 결정과 어지간히 무능한 경영진이 가득한 현실 세계잖아요.
그런 회사들은 로직과 데이터 모델이 뒤엉키는(intertwingling) 고통도 고스란히 겪을 수 있어요. 와아!
이건 기술적 결정이 아니라 문화적 결정이고, 남의 땅에서 질척한 늪 모험을 하고 싶은 기분이 아니라면 저는 가까이 가지 않습니다.
맞습니다. 데이터베이스 안에 머물면서 얻을 수 있는 보장은 문제의 범주 전체를 해결해 주기도 합니다. 하지만 Postgres 안에 사소하지 않은 로직을 두는 DX(개발자 경험)도 썩 좋지는 않아서, 상당한 트레이드오프를 감수하는 느낌입니다. SQL로 컴파일되는 흥미로운 언어도 본 적이 있는데, 경우에 따라서는 고려해 볼 만합니다.
git 기반 블롭 스토리지가 떠오르네요.
쿼리 플래닝을 상태 머신으로 악용하면서 순정 C보다 코드가 짧다니, 엔지니어링 직무유기의 정점입니다. 마음에 들어요.
네, 정말 대단해요! 지금 해보는 중입니다. 언젠가 LLM 추론을 SQL 쿼리로 하면서도 지구의 나이만큼 걸리지는 않는 날이 오면 좋겠어요. 생각보다 훨씬 잘 돌아가네요. 하긴 끝까지 다 SQL이니까요.
프로젝트를 소개한 cedardb.com 블로그 글은 지금 슬래시닷 효과로 접속이 안 되는데, 게임 자체는 문제없이 플레이됩니다.
주제에서 벗어난 질문인데요, 계산하는 데 아주 오래 걸리는 프로그램이 있다면 하드웨어 고장이 나도 처음부터 다시 계산하지 않으려면 어떻게 해야 하나요?
보통은 처음부터 다시 할 필요가 없는 중복 계산을 씁니다. 중간값을 계산해 두고 다음으로 넘어가기 전에 그 값을 확인하는 식으로요.
그건 이미 할 수 있을 것 같은데요. 가중치를 테이블에 저장하면 되잖아요...
행렬 곱셈은 결국 크로스 조인 위의 집계 합계일 뿐이니까요.
SQL을 CUDA 커널로 컴파일하는 쿼리 플래너를 만든다
Postgres용 VRAM 상주 백엔드를 만든다
???
이익!
내 사람들이다!
https://github.com/seanwevans/pg_shell
https://github.com/seanwevans/pg_gpt2
https://github.com/seanwevans/pg_os
https://github.com/seanwevans/pg_git
멋지네요.
게임 상태가 SQL 테이블이라는 얘기를 들으니 1년 동안 최적화에 매달렸던 기억이 떠오릅니다. 2010년에 카지노 게임을 만들 때, 모든 원격 호출이 진실의 원천(source of truth)으로 쓰는 SQL 테이블의 게임 상태를 갱신하게 했는데, 이게 좋은 결정이었는지 나쁜 결정이었는지는 지금도 확신이 서지 않습니다. 플레이어가 여러 명이면 문제가 가끔 생기리라는 걸 짐작하실 겁니다. 초기의 데드락 문제는 끔찍했고, 확장은 악몽이었습니다. 하지만 모든 게 원자적(atomic)이었습니다. 한 턴이 서버에 도달하지 못하거나 데드락에 걸리는 경우를 빼면 데이터를 잃을 위험이 없었고, 거대한 nodejs 프로세스가 모두의 호출을 한꺼번에 받다가 막히거나 메모리를 날려 버리는 일도 없었습니다. 항상 상태가 있었으니까요.
돌이켜보면 턴제 멀티플레이어 게임에는 나쁘지 않은 설계 패턴 같습니다. 문제점만 해결할 수 있다면요. 원자성은 적어도 날아가지 않는 일관된 상태가 존재한다는 걸 보장해 주니까요. 액션 게임에서 그 읽기/쓰기 루프를 돌린다고요? 순수한 미친 짓이지만, 저는 그게 꽤 웃깁니다.
『데이터 중심 애플리케이션 설계』(Designing Data Intensive Applications)에는 말씀하신 성능 손실을 피하면서 원자적 트랜잭션의 동시성 문제를 다루는 내용만 따로 다룬 장이 통째로 있습니다. 분명 흥미로우실 거예요.
https://www.oreilly.com/library/view/designing-data-intensive-applications/9781098119058/ch08.html
눈을 가늘게 뜨고 뇌 손상은 못 본 척하면, SQL은 좀... 함수형이긴 해요.
거의요. 어떤 면에서는요.
"[학습 데이터에 엄청나게 많은 것]을 [학습 데이터에 엄청나게 많은 언어]로 했습니다"가 AI 관심 끌기의 정점인 것 같네요.
정말 인상적인 작업입니다. README에 따르면 직접 돌려 보려면 cedardb 커뮤니티 에디션이 필요하다고 하는데, 다른 데이터베이스 엔진에서도 동작할지, 아니면 cedardb의 특정 기능을 쓰는지 궁금합니다.
저는 WordPress에서 동적 콘텐츠를 당밀처럼 느리지 않게 불러오는 것조차 못 하는 무능한 사람인데 말이죠.
제가 즐겨 드는 비유는 식료품점에 가서 토마토를 달라고 했더니 점원이 먼저 카운터 밑 어딘가의 선반에서 꺼내 와야 하는 상황이에요.
당신 탓이 아니에요, WordPress 탓이죠.
LINQ 레이트레이서가 생각나네요. https://github.com/lukehoban/LINQ-raytracer
심지어 Y 컴비네이터(ycombinator)도 쓴답니다 :D