요약
세레브러스가 1조 파라미터가 넘는 모델을 웨이퍼 여러 장에 나눠 초당 1,000토큰 이상으로 돌리는 방법을 공개했습니다.
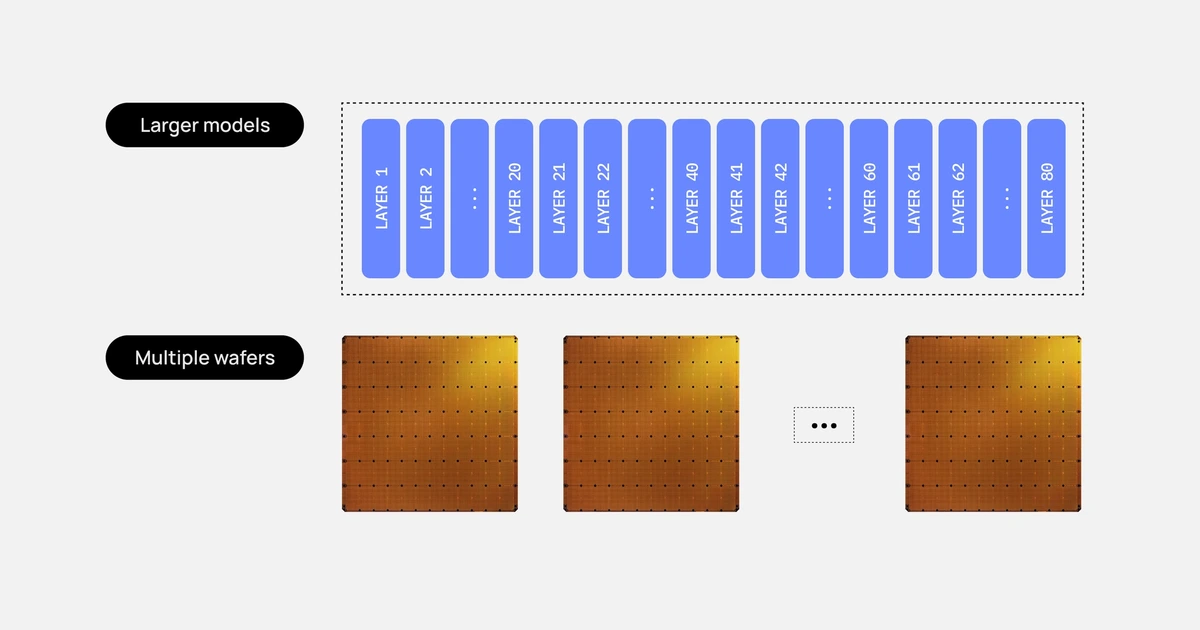
세레브러스가 회사 블로그에 올린 기술 설명 글입니다. 오픈소스 모델 Kimi K3(약 3조 파라미터)를 예로 들어, 거대한 모델을 자사 칩 WSE-3T 여러 장에 나눠 싣는 계산 과정을 단계별로 보여 줬습니다.
왜 중요한가
- 웨이퍼 한 장의 메모리가 44GB에 그쳐 큰 모델을 담기 어렵다는 약점을, 여러 장을 잇는 방식으로 넘을 수 있다고 주장합니다.
- 웨이퍼를 더할 때마다 연산과 메모리가 함께 늘어나므로, 3조 파라미터보다 큰 모델도 같은 계산법으로 배치할 수 있다고 했습니다.
- 효율은 같은 출력 속도에서 전력당 처리량(메가와트당 초당 토큰 수)으로 비교해야 한다는 기준을 내놓았습니다.
핵심 내용
- 가중치를 4비트로 줄이면 층 하나가 약 16GB라서, 웨이퍼 한 장의 SRAM(칩 안의 고속 메모리)에 들어갑니다.
- 선형 어텐션 층은 요청마다 작은 고정 상태만 두므로 웨이퍼 한 장에 두 개씩 싣습니다.
- 전체 어텐션 층은 KV 캐시(앞선 토큰 정보를 저장하는 공간) 자리를 남기려고 한 장에 하나씩 둡니다.
- 그 결과 선형 층 69개에 35장, 전체 어텐션 층 24개에 24장으로 모두 59장이 필요합니다.
- 웨이퍼마다 파이프라인(요청이 단계를 차례로 거치는 구조)의 한 단계를 맡고, 웨이퍼 사이에는 중간 계산값만 넘깁니다.
HN 반응
- 속도는 놀랍지만 일반 개발자가 쓸 수 있는 모델이 GPT OSS 120b처럼 낡았다는 불만이 많았고, 오픈 모델은 몇 달 늦을 뿐이라는 반론도 나왔습니다.
- 오픈AI 최신 모델의 초고속 모드도 엔비디아 GPU로 운영된다는 지적과 함께, 웨이퍼를 대량 생산하기 어려워 수요를 못 따라간다는 분석이 이어졌습니다.
여기 많은 분들이 세레브라스가 낡은 모델만 서비스한다고 하시더군요.
제 생각은 이렇습니다. 그 말이 맞다고 치고, 평균적으로 6~9개월 늦게 서비스한다고 해 봅시다. 그렇다면 몇 달 안에 DS flash v4, glm 5.3, mimo 2.6 pro, kimi 3.1 pro 같은 모델을 서비스하기 시작할 거라고 기대하는 게 합리적입니다. DS flash는 이미 너무 빨라서 제가 병목이 될 지경입니다. 요점은 이겁니다. 세레브라스는 머지않아 프런티어 모델과 그리 멀지 않은 더 나은 모델을, 훨씬 낮은 비용에 몇 배 빠른 속도로 내놓을 겁니다.
느긋하게 기다리면서 앞날을 준비하세요.
세레브라스에서 Sol 6.1 Ultrafast를 서비스하고 있지 않나요?
아니요, 세레브라스가 서비스하는 건 GPT-5.6-Sol(7월 출시)입니다.
OpenAI는 최신 모델의 ultrafast 모드에 다시 엔비디아 칩(작은 배치 크기)을 쓰고 있습니다.
그래서 속도가 세레브라스에서의 750tok/s에서 300tok/s로 떨어지고, 아마 세레브라스 쪽보다 비용도 훨씬 더 들 겁니다. 하지만 세레브라스는 공급에 제약이 있습니다. 이번 분기에 데이터센터를 공격적으로 확장할 계획인 것으로 알고 있는데, 엔비디아 칩보다 규모를 키우기가 훨씬 어렵습니다.
오픈 모델은 그 자체로 3~6개월 뒤처져 있습니다.
제가 테스트해 본 바로는, 세레브라스의 문제는 신규 고객을 끌어들이려면 맛보기를 줘야 하는데, 그 속도를 내려면 하드웨어가 너무 많이 필요하고, OpenAI 같은 자금력도 없고(30억 달러 미만 대 1,000억 달러 이상), 이런 거대한 웨이퍼 노드를 그만큼 많이 만드는 것 자체가 어쨌든 엄청나게 어렵다는 점입니다. 수요를 따라갈 방법이 없습니다.
그래서 누구나 놀라운 속도를 살짝 맛볼 수 있는 저렴한 요금제를 두는데, 영업용으로 따로 떼어 둔 한정된 자원을 나눠 써야 하니 전혀 믿을 만하지 않습니다. 월 50달러짜리 요금제 같은 건 사실상 영업 깔때기의 일부가 주목적이라고 봅니다. 저렴한 요금제는 "진짜" 돈을 내는 기업 고객에게 필요한 자원을 직접 잠식합니다.
"진짜" 요금제는 월 1,500달러쯤부터 시작하는데, 그쪽은 서비스 수준과 안정성이 제대로일 거라고 짐작합니다.
그런데 저는 그 월 1,500달러짜리 요금제가 어떤 용도에서는 충분히 값어치를 한다고 생각합니다.
그런 수준의 단일 사용자 처리량이 필요한 용도가 뭔가요? 에이전트 작업은 대부분 도구 호출 비중이 크고, 나머지는 서브 에이전트를 써서 병렬로 처리하는 편이 처리량 면에서 더 낫잖아요.
헤지펀드라면 목표 기반 전략을 대규모로 굴리는 LLM이 활용하도록 특별히 만든 도구 파이프라인을 구축할 법해 보입니다.
세레브라스는 서류상으로는 좋은데, 제가 현실적으로 접근할 수 있는 건 "GPT OSS 120b, Qwen 3.8 27B"뿐이고, 둘 다 제 용도에는 별로 쓸 만하지 않습니다.
Openrouter의 nitro로도 그 근처까지는 갑니다. TPS는 여전히 5분의 1이지만요.
세레브라스에서 GPT OSS 120b를 써 봤는데, 날아다니긴 합니다. 그런데 대부분 틀려요.
이 빠른 모델들이 지금 와서는 너무 오래됐다는 게 정말 답답합니다. Chat jimmy는 2월에 나왔는데 그 뒤로 아무 진전이 없어요. 정식 출시(GA)는커녕 지능 면에서 개선된 것도 없고요.
지금 AI는 워낙 빠르게 움직여서 그 정도면 평생이나 마찬가지입니다.
앤트로픽과 OpenAI에서는 몇 주마다 SOTA 모델이 나오는데, 쓸모 있는 한 가지(예: opus)에 집중하는 듯하다가 식당 예약 같은 쓸데없는 다섯 가지를 덧붙입니다. 우리는 정말 유용한 응용 분야를 왜인지 외면하고 있어요.
Jev가 나와서야 판이 흔들렸습니다. "이걸 원하는 사람이 있다고? 대형 연구소들은 이런 거 어딘가에 굴러다니는 버전 하나쯤 갖고 있을 텐데" 하는 반응이 대부분이었던 게 기억나는데, 글쎄요, 그 연구소들은 우선순위를 좀 고쳐야 할지도 모르겠습니다.
돈이 안 되니까 외면하는 거라고 봅니다.
Jev는 정말 멋지고, 처음 보는 분류까지 처리할 수 있다는 것도 멋집니다. 하지만 대부분의 조직은 새로운 분류 작업에 큰돈을 쓰지 않습니다. 같은 일을 수십억 번 반복하니까, Jev는 맞춤형 모델을 직접 만들어 자체 추론을 돌리는 방식과 경쟁해야 합니다.
Jev처럼 범용적인 걸 만들기는 아주 어렵지만, 한 가지 종류의 작업만 처리하는 더 구체적인 걸 만드는 건 꽤 할 만합니다. 특히 OpenAI가 여러분에게 관심을 가질 만한 규모에서는요.
저는 신경망을 잘 이해하지 못하는데도 오래된 Leap Motion으로 손동작 인식 모델을 학습시켰습니다. 꽤 한정된 영역이긴 하지만, 10년 된 노트북 CPU로도 3분 안에 학습됩니다. 정확도도 상당히 좋고요. Leap 쪽 오류(어느 손가락이 펴졌는지 잘못 인식하는 것 같은)를 빼면 더 그렇습니다.
Jev 얘기가 나오면 다들 일반화가 결국 이긴다는 "쓰라린 교훈(bitter lesson)" 이야기를 꺼내길 좋아합니다. 결국엔 그럴지도 모르죠. 하지만 저는 그리 복잡하지 않은 제 용도에 최근의 Jev류 모델을 대부분 시험해 봤는데, 특정 도메인에 맞춘 분류 모델과는 전혀 경쟁이 안 됐습니다.
범용 분류기는 두 가지 면에서 사실 대단합니다.
임의의 맥락과 세상 지식을 바탕으로 한 추론을, 빠르고 구조화된 출력으로 내놓습니다.
사람들이 이미 알아챘는지 몰라서 말하기가 꺼려질 정도인데... 비AI 프로세스나 시스템에서 나온 트레이스(trace)도 "학습 가능"하게 만듭니다. 학습 중에 다음 결과를 예측하게 하고 실제 일어난 일과 비교하기만 하면 쉽게 모델링할 수 있어요.
이는 롤아웃을 통해 의미 공간 전반에 일반화되는 방식으로 새로운 전략까지 학습할 수 있다는 뜻이기도 하고, 그 말은...
그러니까 이 모델들은 기존 기업들에 정말 유망하게 쓸모가 있습니다. 기업들은 자기 회사에서 벌어진 일의 일반적인 트레이스를 실제로 갖고 있고, 업무 프로세스를 조정할 방법을 찾고 싶어 하니까요. 그러면 사용자에게 슬롭(slop)을 노출하지 않고 제품이나 UX 흐름 안에 넣을 수 있는 모델, 그리고 이를 학습·커스터마이징해서 진짜 IP나 맞춤 기능을 만들 수 있는 모델에 대한 지속적인 수요가 생깁니다.
제 생각에 범용 분류 자체는 판단을 내리거나 여러 UX 동작 중 하나를 골라야 하는 응용에서 아주 흥미롭고, LLM보다 훨씬 잘 맞습니다. 생각해 보면 기업들이 많이 호출하게 될 종류의 작업입니다. 모든 트레이스(예: 사용자 세션, 화물 배송, 영업 활동, 마케팅 캠페인, 구인 접촉)에 쓰이고, 동적인 경험 전반에서 선제적으로 통화를 끝낼지, 여러 UI 중 무엇을 조작할지 같은 걸 결정하는 데도 쓰일 테니까요.
다만 지금까지는 강력한 범용 베이스라인으로 부트스트랩할 수 없었기 때문에 대부분의 사람에게 낯선 제품 경험일 뿐입니다. 이제는 가능해졌고, 아주 멋진 일이 될 거라고 생각합니다.
제 말을 오해하신 것 같습니다. 저는 (클라우드든 온프레미스든) 업체들이 LLM을 대신 쓸 거라는 얘기를 하는 게 아닙니다.
저는 훨씬 더 구체적인 목적으로 자체 모델을 학습시키는 경우를 말하는 겁니다.
UI에서 메뉴 옵션을 고르는 얘기를 꺼내셨죠. Jev는 "사용자의 프롬프트에 가장 잘 맞는 메뉴 옵션을 찾아라" 같은 일을 정말 잘합니다. 그건 범용적인 일이고 크고 복잡한 모델이 필요합니다.
기업들은 보통 변동이 더 적은 쪽에 관심이 많습니다. 예컨대 찾는 메뉴 옵션이 정해져 있는 경우요. "임의의 웹사이트에서 로그인 버튼을 찾아라" 같은 거죠. 이건 훨씬 단순한 모델이고, 많은 대기업이 충분히 직접 학습시킬 수 있는 수준입니다.
변수가 너무 많아서 모델이 사실상 범용이어야 할 때만 Jev에 돈을 내면 됩니다.
예를 들어 분류기는 LLM과는 별개의 물건이고, 문자 그대로 구조화된 출력만 낼 수 있습니다. 학습된 X개의 선택지 중 하나를 출력할 뿐이죠.
이런 오해는 AI를 좋아하는 사람과 머신러닝을 좋아하는 사람의 벤 다이어그램이 완전한 원이 아니라서 생기는 면도 있다고 생각합니다. LLM도 아니고 의사결정 모델도 아닌 "지능"이 세상에 많이 있거든요.
당신에게(예: 코딩) 유용한 것이 사람들의 99%에게는 완전히 쓸모없을 수도 있어요.
Chatjimmy는 taalas가 인수했어요.
네, 그리고 AMD가 인수해서 자사 하드웨어에 통합하겠다고 발표했고요.
맞아요. 저도 세레브라스가 지원하는 모델을 가끔 쓰는데, 속도는 놀랍고 거의 즉각적인 추론이 가능하다는 잠재력도 보이지만, 지금은 모델들이 너무 낡았어요.
세레브라스가 이 글을 읽고 있다면, 정신 좀 차리세요. 그러면 주가에도 도움이 될지 모르잖아요. OpenAI 말고도 소비자에게 더 많은 선택지를 주세요.
분명 낡은 모델을 영원히 돌릴 계획이었는데, 이제 댓글을 읽었으니 다시 일할 의욕이 생기겠네요.
토론에 기여해 주셔서 감사합니다.
세레브라스는 상장사가 아니고 거의 확실히 인수되는 식으로 엑싯할 거예요. 그러니 대중에게 보여 주는 데모는 중요하지 않아요.
상장한 지 꽤 됐습니다.
https://www.cerebras.ai/press-release/cerebras-systems-announces-pricing-of-initial-public-offering https://uk.finance.yahoo.com/quote/CBRS/
상장사입니다. $CBRS요.
GPT-5.6 Sol Ultrafast는 세레브라스 하드웨어에서 돌아갑니다.
제가 본 보도로는 그건 제한된 고객에게도 제공된 적이 없습니다. 현재 제공되는 ultrafast인 GPT-6 Astra와 GPT-6.1 Sol은 모두 그럴 만한 이유로 엔비디아를 씁니다 [0].
OpenAI처럼 자기네 하드웨어에 올리게 해 달라고 바짓가랑이를 붙잡는 의지 있는 대형 고객이 있는 세레브라스가 이제 와서 2.8T 오픈 웨이트 모델에 대한 글을 올린다는 사실이 많은 걸 말해 줍니다.
[0] https://blogs.nvidia.com/blog/gpus-openai-gpt-6-astra-ultrafast/
6.1 sol은 ultrafast로 쓸 수 있습니다.
그런데 openrouter에서는 6.1 sol ultrafast의 tps가 보통 opus 5.5 fast보다 낮습니다. 사용자 밀도가 낮은 엔비디아보다는 세레브라스 하드웨어가 당연히 더 빠를 텐데, 측정값이 이상한 걸까요?
https://openrouter.ai/openai/gpt-6.1-sol
GPT-6.1 Sol Ultrafast도 세레브라스가 아니라 엔비디아 하드웨어를 씁니다. 평소 추론을 제공하는 방식보다 자원을 훨씬 넉넉하게 배정해서 처리량이 더 높을 뿐이에요.
"훨씬 넉넉하게 배정"이라고 하면 과장일 수 있습니다. 핵심은 엔비디아 GPU 한 장당 고객을 아주 적게 받는 건데, 문제를 해결하는 방법치고는 비싼 방식입니다.
그럼 OpenAI는 세레브라스를 어떻게 쓰고 있는 건가요? 아니면 안 쓰는 건가요?
아니면 관점을 바꿔서, 누가 세레브라스를 무슨 목적으로 쓰고 있나요?
제가 알기로는 Jane Street가 세레브라스 x OpenAI 컴퓨트를 전부 사들였습니다. 괜찮은 출처는 못 찾았지만, 이 트윗에 다른 출처를 인용한 답글이 꽤 많이 달려 있어요 https://x.com/cryptopunk7213/status/2106834536868856223
아, 그러면 이해가 되네요. 결국 공급이 제한된 거군요.
"개발자"에게는 제공되지 않습니다.