요약
Intel 8087의 덧셈과 뺄셈은 단순해 보이지만 안에는 정렬, 정규화, 특수값 처리가 겹겹이 숨어 있습니다.
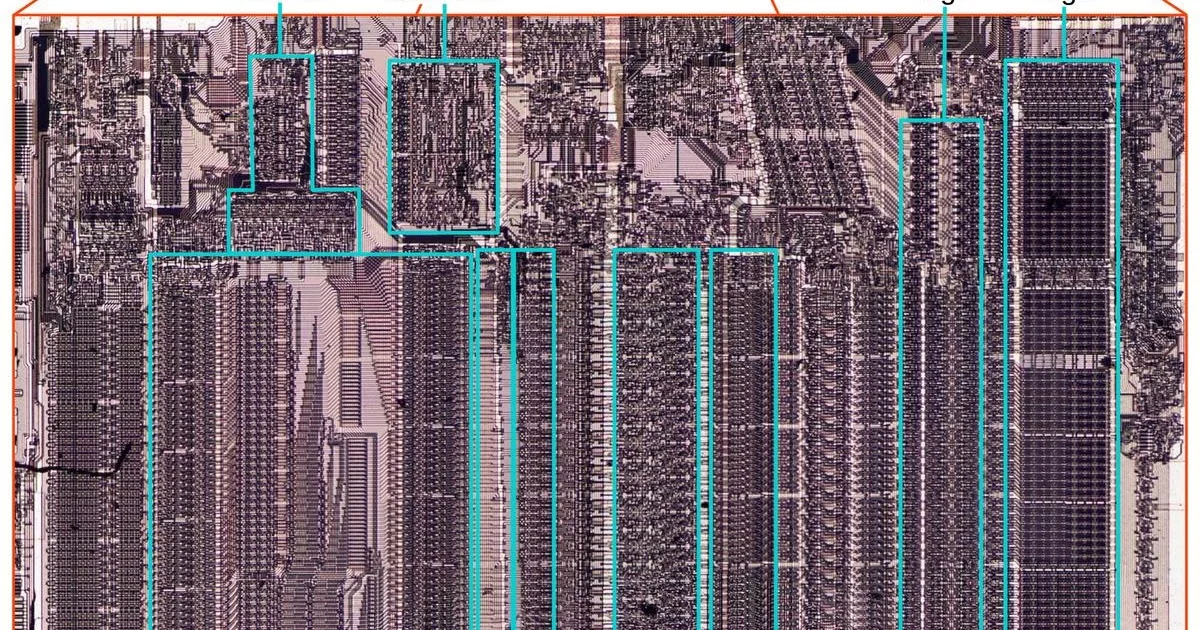
칩 역공학으로 알려진 켄 시리프가 1980년 인텔의 수치 보조 프로세서 8087을 분석하는 연재의 새 글입니다. 칩의 다이(실리콘 본체) 사진과 마이크로코드(칩 내부의 저수준 명령) ROM을 읽어 덧셈과 뺄셈의 동작을 따라갔습니다.
왜 중요한가
- 오늘날 컴퓨터가 따르는 ±0, ±무한대, NaN(숫자가 아님) 규칙이 8087에서 시작해 IEEE 754 표준으로 이어졌습니다.
- 반대로 투영 무한대 같은 8087 기능은 들인 노력에 비해 쓸모가 적어 표준에서 빠졌다는 점도 보여 줍니다.
- 인텔 문서 기준으로 8087의 덧셈은 8086의 소프트웨어 에뮬레이션보다 100배 가까이 빨랐습니다.
핵심 내용
- 덧셈은 지수가 작은 쪽의 가수(유효숫자 부분)를 지수 차이만큼 오른쪽으로 밀어 자리를 맞춘 뒤 정수로 더합니다.
- 두 값의 부호와 연산 종류를 XOR로 묶어 실제로 크기를 더할지 뺄지 정합니다.
- 뺄셈은 앞자리가 상쇄되며 생긴 0을 지우려고 왼쪽으로 크게 밀어야 할 수 있다는 점이 덧셈과 다릅니다.
- 앞자리 0을 세는 회로는 64비트를 한 번에 보지 않고 바이트 단위와 비트 단위 두 단계로 나눠 회로를 줄였습니다.
- 특수값을 처리하느라 사칙연산이 함께 쓰는 마이크로코드에 조건 분기 18개가 연달아 나옵니다.
HN 반응
- 80비트 확장 정밀도를 두고 반올림 오차가 줄어 더 정확했다는 쪽과, 64비트로 내려 저장하면 결과가 들쭉날쭉했다는 쪽이 맞섰습니다.
- 수학 보조 프로세서를 달면 스프레드시트 재계산이 크게 빨라졌다는 당시 경험담도 여럿 이어졌습니다.
저는 8087이 정말 멋지다고 늘 생각했는데, 끝내 자리를 잡지는 못했죠. 초기 Win32는 컨텍스트 스위치 때 8087 레지스터를 저장하지 않았습니다. 제가 마이크로소프트 사람들에게 전화해서 제발 8087을 망가뜨리지 말아 달라고 했고, 그쪽에서 받아들여 레지스터를 보존해 주었습니다.
저는 제 컴파일러로 8087을 지원해 온 것이 늘 자랑스럽습니다. 그런데 수치 계산 하는 사람들이 왜 8087을 무시하는지는 도무지 이해가 안 됩니다.
그 시절에는 8087과 80287을 지원하는 소프트웨어(스프레드시트, 통계 프로그램 등)가 꽤 많았습니다. 제 첫 개발자 일자리(당시 15살이었습니다)에서 제 AT 호환기에 80287이 들어 있다는 이유로 회계사들이 쓰는 1-2-3 모델을 제가 다시 계산해야 했습니다. 그 일 덕분에 1년 뒤 386과 387을 사 달라고 했을 때 흔쾌히 승낙을 받았죠. 제가 쓴 사유서에는 a) 컴파일이 더 빨라지고, 필요할 때 b) 재무 모델을 더 빨리 재계산할 수 있다고 적었습니다. 그 모델이 287에서는 5분쯤 걸렸고 386+387 구성에서는 40초쯤 걸렸는데, 넉넉했던 4MB 램이 더 큰 몫을 했을 거라고 생각합니다. 수학 보조 프로세서에 몇백 달러 더 내는 걸 사람들이 왜 꺼렸는지 저는 지금도 이해가 안 됩니다. 소프트웨어가 지원하기만 하면 확실히 빨라졌거든요.
제가 HN에 오는 이유가 바로 이런 글 때문이에요.
"수치 계산 하는 사람들이 무시했다"고요?
월터, 저는 잘 모르겠네요. PC 시스템에 들어간 최초의(?) IEEE754 구현이었는데, 수치 알고리즘을 다루던 우리에게는 정말 엄청난 사건이었거든요. 저한테는(당시 대학원생이었습니다) 얼마나 큰 일이었는지, 8087 칩을 평생 간직해 왔고 지금도 눈앞에 두고 있습니다. 지난번 이사 때 이 녀석이 핀 하나를 잃어버렸네요. 젠장.
핀이 있는 쪽에 "3716150AA MALAY BEV 22"라고 양각되어 있는데, 검색해도 아무것도 안 나옵니다.
제가 말한 건 80비트 부동소수점을 무시했다는 뜻이었습니다. D에서 80비트 연산을 했다고 반발을 꽤 많이 받았거든요.
감사합니다. 저는 컴파일러 쪽 과정은 잘 모릅니다. 당시 수치 알고리즘을 하던 사람으로서 제가 가졌던 생각은, x87 칩이 80비트 연산을 내부에서 불투명하게 처리하고 눈에 보이는 결과만 32/64비트 IEEE754 부동소수점 형식의 바이트로 돌려준다는 것이었습니다.
이게 틀린 건가요? 아니라면 남는 16비트(배정밀도)는 어떻게 저장하셨나요? 그때 조텍 컴파일러를 샀어야 했나 봅니다. ;-)
볼랜드가 터보 파스칼로 저를 낚아 놓고는 터보 C/C++로 뒤통수를 쳐서 지금도 서운합니다.
FLD와 FSTP에는 메모리 주소에서 10바이트를 읽고 쓰는 오피코드 변형이 있습니다.
단점은 물론 10바이트가 꽤 어정쩡한 크기라는 점입니다. 32/64비트만큼 빠르게 넣고 빼지 못하고, 반드시 메모리여야 하며(다른 레지스터를 빌려 쓸 수 없습니다), 데이터 구조 정렬 같은 데 미치는 영향도 따져 봐야 합니다.
8087이 IEEE 754, 그러니까 현대 부동소수점 전체에 가장 큰 영향을 준 건 맞으니, 그런 의미에서 수치 계산 하는 사람들이 8087을 무시하는 건 아닙니다.
x87 부동소수점 유닛의 가장 큰 문제는 명시적 정수 비트 때문에, 일반적인 IEEE 754 부동소수점 형식에서 기대하는 성질이 없는 이상한 80비트 부동소수점 형식에서만 제대로 동작한다는 점입니다. 이 설계 탓에 더 흔한 32비트·64비트 단정밀도와 배정밀도 연산을 비트 단위까지 똑같이 에뮬레이션하기가 어렵습니다. 여기에 많은 컴파일러가 부동소수점 레지스터를 잘못 스필하기로 한 결정까지 겹칩니다. 80비트가 아니라 32비트나 64비트로 스필하는 바람에 프로그램의 수치 결과가 사실상 제멋대로가 됩니다. 게다가 80비트 형식은 크기가 벡터화에 별로 유리하지 않아서, SIMD 프로그래밍이 중요해지면서 부동소수점 유닛은 뒤처지게 됐습니다.
그래서 x87은 결국 IEEE 754 이전 부동소수점 체계 중 지금까지 남아 있는 마지막 존재인 셈입니다. 벤더마다 부동소수점 체계가 다르던 환경에서는 흥미로웠을 특징 상당수가, 모두가 같은 체계를 따르는 지금은 그저 쓸모없이 남은 기벽일 뿐이라 지원할 가치가 없습니다.
8087이 나왔을 때 세계 최고의 수치 연산 프로세서는 크레이와 CRI의 여러 제품이었습니다. 8087의 확장 레지스터 형식을 이 정도로 아신다면 최하위 비트 처리에 대한 시모어의 견해가 실리콘에 어떻게 구현돼 있는지도 이미 아실 겁니다. 저는 갓 박사가 된 계산수학자로서 크레이 시스템이 장시간 계산에서 정확도가 괜찮을지 걱정했습니다. 그런데 세계 처리량 1~4위 시스템의 최전선에서 5년을 일하고 나니, 중요했던 계산에 실질적인 영향을 준 건 기억나는 한 하나도 없었습니다. 시모어가 저보다 똑똑했던 거죠. 저는 삽이나 들었어야 했나 봅니다.
8087이 실제로 내놓은 정확도로 말하자면, 64비트가 아니라 80비트로 연산했기 때문에 확장되지 않은 형식보다 더 나았습니다. 어쨌든 자세한 내용은 여기서 읽어 보실 수 있습니다.
https://en.wikipedia.org/wiki/Extended_precision#x86_extended-precision_format
카한이 보증했다는 것만으로 저한테는 충분했습니다.
그때 세부 사항은 기억나지 않지만, 초기 선의 자바 구현이 이걸 가지고 뭔가 이상한 짓을 했습니다.
선은 JVM이 머신이 달라도 "정확히 똑같이 재현"되기를 원해서 모든 중간 연산의 정밀도를 64비트나 32비트(double/single)로 잘라 버렸고, 이게 카한을 격분시켰죠.
아하! 감사합니다. 선의 부동소수점 담당자들은 세계적 수준이었지만, 저는 그래도 이건 멍청한 짓이었다고 생각합니다.
NAS Parallel Benchmarks를 할 때 우리는 가능한 한 다양한 하드웨어와 알고리즘을 장려하려고 했기 때문에, "올바른" 동작으로 인정하는 "유효" 구간을 너그럽게 잡았습니다. 이단적인 크레이 부동소수점은 이미 이야기했죠. 대단한 시스템들이었습니다. 이상하거나 색다른 알고리즘이든 아키텍처든 성능·효율에서 최고 수준을 의미 있게 끌어올린다면 절대 탈락시키지 않았을 겁니다. 반면 정확도 요건을 확고하게 두는 것 자체를 두고는 전쟁이 벌어졌습니다. 그러니 이 JVM 건은... 잘 봐줘야 무의미한 짓이었다고 해야 할까요?
이건 정말로 있었던 과거에 대한 향수일 뿐입니다. 친구들, 그때가 좋았죠.
다중 정밀도 라이브러리를 구현해 본 적 없는 사람다운 말씀이네요. 다행히 선의 생각이 이겼고, 레지스터 스필 때 80비트가 64비트로 둔갑하던 일은 먼 과거가 됐습니다. 지금 프로세서는 전부 float64의 +-*/ 연산을 완전히 결정적으로 구현하기 때문에, 쿼드 부동소수점, 다중 정밀도, 구간 산술 같은 것을 위한 제대로 된 이식 가능한 라이브러리를 만들 수 있습니다.
아, 이제 다중 정밀도 라이브러리 이야기로 넘어가는군요. 이런 라이브러리가 존재하는 기본 이유는, 정밀도 형식이 다르면 경제적으로 의미 있는 결과가 달라지고, 그것이 그리 많지 않은 경제적으로 의미 있는 트레이드오프들을 통해 나타나기 때문입니다.
80비트 형식은 당시의 엔지니어링 최적화였습니다. 반올림 동작이 더 좋아서 "비용 없이" 당시의 배정밀도(DP)를 더 매력적으로 만들었죠.
그래서 (제가 답을 모르는) 흥미로운 질문은 이겁니다. "비결정적인" 80비트 내부 DP에서 "결정적인" 4배 정밀도(QP)로 정확도를 올리는 것이 경제적으로 언제나 더 낫습니까?
주어진 예산에서 계산 문제가 무엇이냐에 달렸습니다. 그리고 그 예산으로는 시장에 나와 있는 것만 살 수 있습니다.
저는 기술 단일 문화가 좋은 것이라고 생각했지만, 지금 상황을 보고 생각을 바꿨습니다. 그래도 당신 삶이 단순해졌다니 다행입니다.
저는 구간 산술을 40년 동안 가볍게 지켜봐 왔습니다. 아시다시피 알고리즘 민감도 정보는 필수입니다. 우리는 그때 인텔 80비트 부동소수점으로 그걸 평가했고, 느리긴 했습니다. 구간 산술은 알고 있었지만 쓰지 않았습니다. 경제성이 없었으니까요. C++, 우리한테 뭘 해 줄 수 있지? 템플릿이라니, 젠장.
지금은 구간 산술이 경제적으로 얼마나 중요합니까?
제 컴파일러들은 제대로 동작했습니다.
1980년 칩이 80비트 부동소수점을 할 수 있었다니 좀 충격적이네요. 올해 나온, 46년이나 지난 마이크로컨트롤러들이 부동소수점을 아예 지원하지 않거나 기껏해야 32비트인 걸 생각하면 살짝 화가 납니다. 그런 주제에 "보안 아일랜드"와 ET에게 전화를 걸 수 있는 무선은 달고 나오죠.
맞아요, NASA조차 그렇게 많은 비트는 필요 없어요. 켄이 직접 말했잖아요. https://news.ycombinator.com/item?id=40971913
하지만 할 수는 있어요. 그 일을 위해 특별히 만든 하드웨어로 가속되지 않을 뿐이죠.
에스프레시프가 ESP32-S3에 FPU를 마침내 다시 넣었습니다. (원래 ESP32에도 들어 있었고요.)
H 라인과 P 라인에서는 FPU를 일반 제품보다 돈을 더 받는 추가 옵션으로 만들려고 했습니다. 그래도 시장이 반대하자 받아들이긴 했죠.
8087 글을 또 하나 쓴 저자입니다. 다음에는 8087의 어떤 부분을 살펴보면 좋을까요?
righto.com은 정말 재미있게 읽고 있습니다. 제 친구들은 아무도 8087에 돈을 쓰려 하지 않았지만, 저는 (두 번째로) 학교를 마치고 나와서 친구 셋이 486DX를 사는 걸 지켜본 뒤 돈을 모아 486DX를 샀던 게 지금도 기억납니다. 그 뒤로는 뭐, 정말 굉장한 여정이었죠.
사소한 정오표입니다. "1.1 (binary) × 2^8 is 304"는 384여야 합니다.
고맙습니다! 그 숫자를 읽을 때 안경을 안 썼던 모양이에요 :-)
요즘 P6 마이크로코드를 두고 활발한 공동 작업이 이뤄지고 있습니다. 새 아키텍처에서 옛 ISA를 지원하는 데 어떤 우여곡절이 있는지 보고 싶습니다.
와, 쓰레기 글의 바다 속 한 줄기 빛 같은 켄이 있어서 정말 다행입니다. 그 오랜 세월 동안, 셀 수 없이 많은 시간을 들여 쓴 글과 영상 모두 고맙습니다.