요약
제인 스트리트가 사내 메시지 버스 Aria에 토픽 묶음별 인덱스를 붙여 복구 부하를 줄였습니다.
제인 스트리트가 2026년 여름 인턴 프로젝트를 소개하는 연재 글입니다. 인턴 테오도르 토테프가 Aria 팀과 함께, 하루 수 테라바이트를 나르는 Aria의 복구 경로를 고친 과정을 담았습니다.
왜 중요한가
- 서버를 더 붙이는 임시방편 대신 읽는 방식을 바꿔, 뒤처진 클라이언트가 몰릴 때의 CPU 포화를 풀었습니다.
- 저장소를 토픽 이름이 아니라 메시지 양으로 나누면, 사용자가 Aria 내부 구조를 몰라도 토픽을 설계할 수 있습니다.
- 에이전트로 싸게 실험하고 엄격하게 테스트하는 방식이 메시지 순서가 중요한 시스템에서도 통했다고 봤습니다.
핵심 내용
- 예전에는 요청마다 링 버퍼(최근 메시지를 담는 고정 크기 메모리) 전체를 훑어 일부 서버의 CPU가 100%에 닿았습니다.
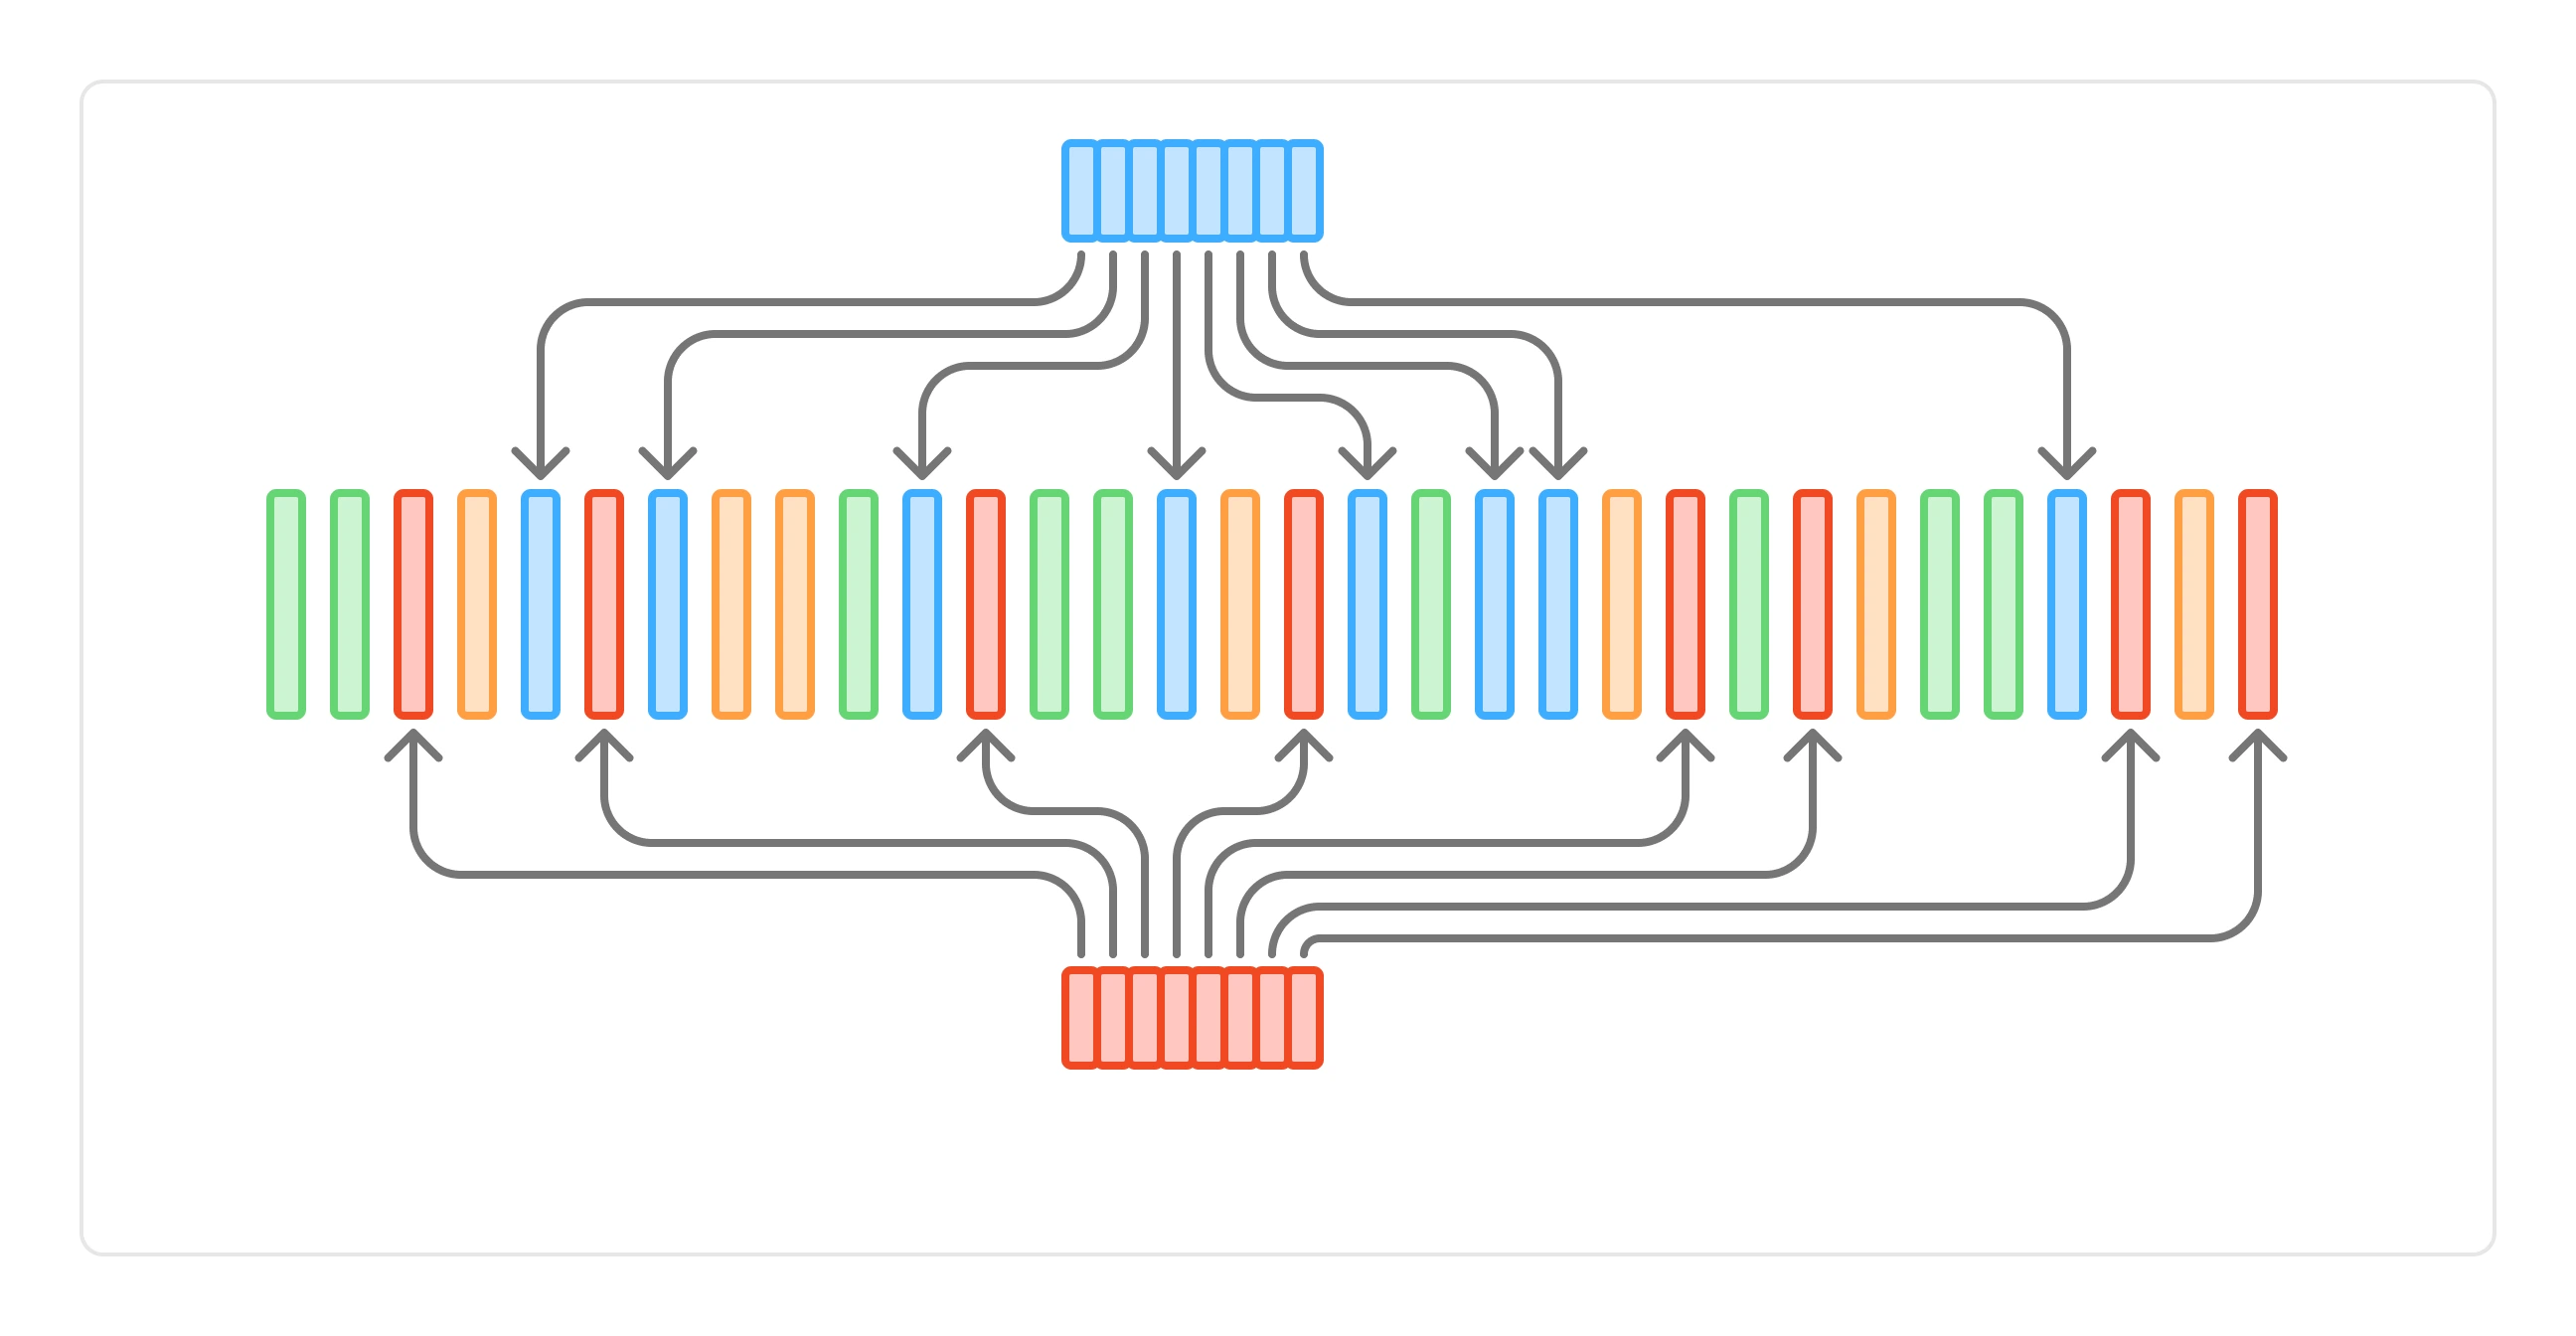
- 토픽을 앞 두 마디(예: app/codestore)로 묶은 파티션마다 인덱스를 두고, 읽을 때 최소 힙으로 병합합니다.
- 인덱스는 1,024개 항목짜리 블록을 공용 풀에서 빌려 쓰므로 파티션마다 최악의 경우인 2GB를 잡아 둘 필요가 없습니다.
- 큰 토픽은 따로, 작은 토픽은 함께 묶는 분할 방식으로 13분까지 늘었던 초기 복구 문제를 겨냥했습니다.
- 에이전트로 힙 구현 다섯 가지를 비교해 복구가 2배 빨라졌고, 초기 결과에서 CPU 사용량이 30% 줄었습니다.
HN 반응
- 선형 탐색은 규모가 커지면 무너진다는 의견에, 정확도가 중요하면 단순한 선형 탐색이 나을 때도 있다는 반론이 붙었습니다.
- 메시지 버스는 단일 장애점(멈추면 전체가 멈추는 지점)이니 구독자 수를 줄여야 한다는 지적도 있었습니다.
이거 보니 웃기네요. 제가 본 금융권 면접은 하나같이 최소 힙(min heap)으로 이것저것 푸는 문제가 꼭 들어 있거든요.
이 문제를 풀기에 이렇게까지 준비된 엔지니어 집단은 일찍이 없었을 거예요.
선형 탐색은 규모가 커지면 한계에 부딪힙니다. 접두사별로 파티셔닝하고 1024개 항목짜리 블록을 풀링해서 쓰는 것이, 최악의 경우 인덱스가 2GB까지 부푸는 것을 막는 올바른 방법입니다.
맞습니다, 한계에 부딪히기는 합니다. 다만 그게 얼마나 중요한지는 상황에 따라 크게 다릅니다. 정확도와 시간 사이의 트레이드오프라는 것이 존재하고(요즘 $WORK에서도 꽤 흔합니다), 선형 탐색보다 나은 방법이 없다는 것이 증명되어 있고 그 덕에 비즈니스 차원에서 정확도까지 얻을 수 있다면, 차라리 그쪽으로 마음을 굳히고 CPU 친화적인 아주 단순한 알고리즘을 고르는 편이 낫습니다.
제가 보기에 버스는 앱이나 서비스가 되도록 의존하지 않는 편이 좋은 단일 장애점처럼 보입니다. 모든 것을 버스에 발행(publish)하지 말아야 한다고 주장하지는 않겠지만, 구독자 수는 최소로 줄여야 한다고 주장하겠습니다.