요약
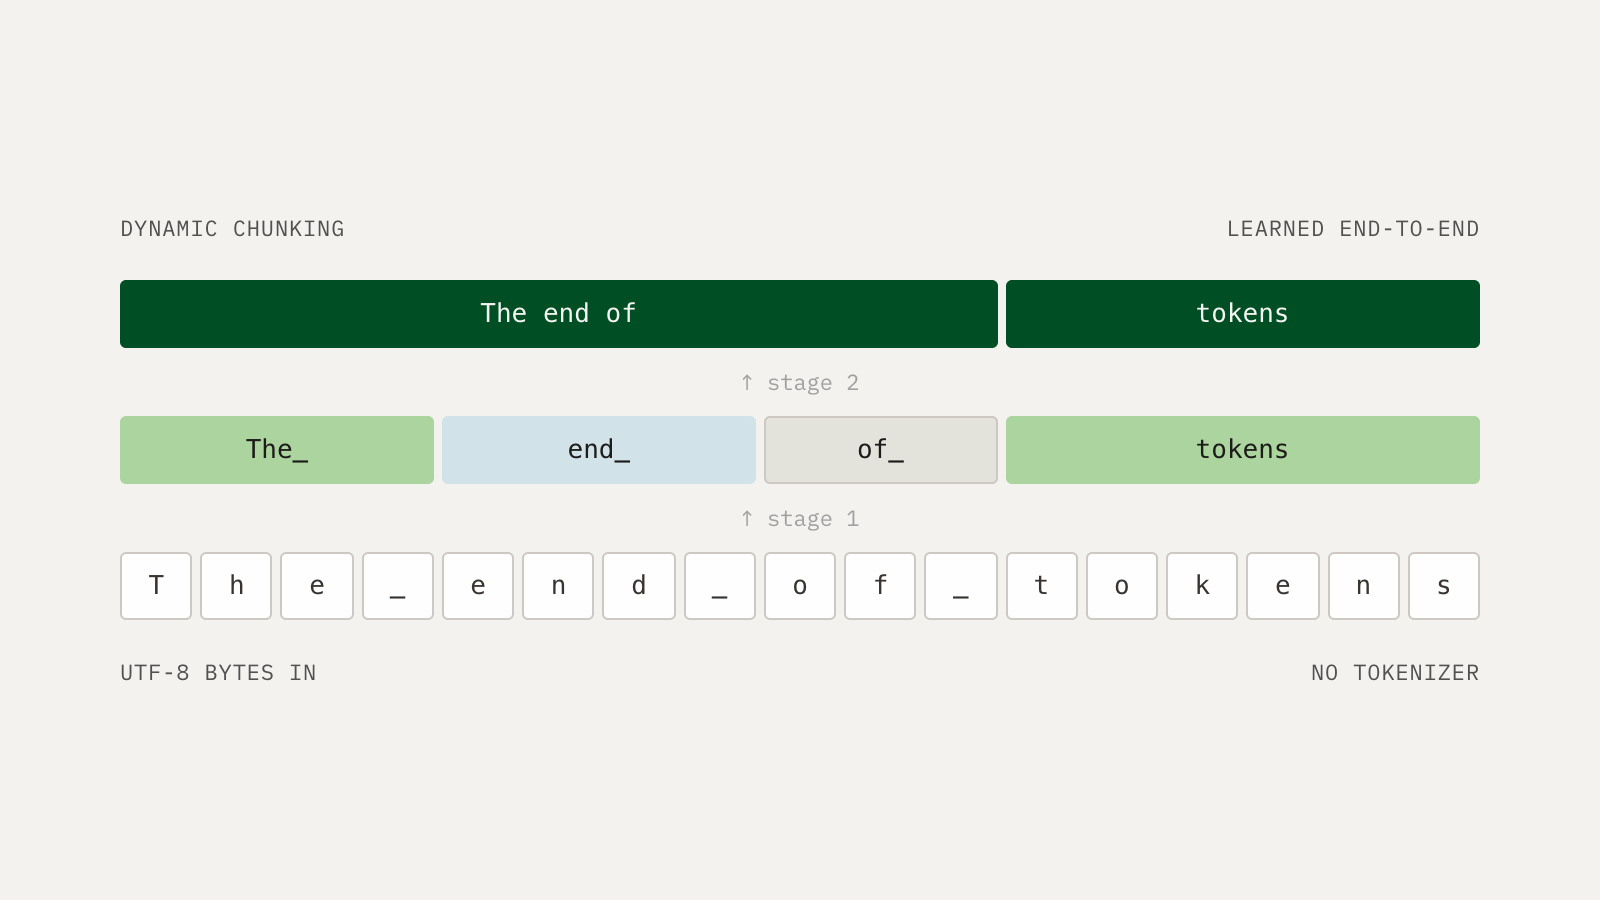
토크나이저 없이 바이트를 직접 배우는 H-Net이 3B 트랜스포머를 10분의 1 데이터로 따라잡았습니다.
카르테시아 연구팀이 2부작 글의 첫 편에서 밝힌 결과입니다. 연구팀은 언어 모델이 사람이 만든 토크나이저(텍스트를 미리 정한 조각으로 자르는 도구)에 기대는 한 원시 데이터에서 끝까지 배울 수 없다고 봅니다.
왜 중요한가
- 텍스트를 자르는 단위를 모델이 직접 배우게 하면 오히려 학습 효율이 오른다는 근거입니다.
- 같은 구조가 DNA와 이미지에도 통해, 쓸 만한 토크나이저가 없던 분야로 넓힐 길이 생깁니다.
- 학습하지 않은 프로그래밍 언어 10종에서 이득이 중앙값 3.1배로 더 커서, 처음 보는 데이터에 강할 수 있음을 보여 줍니다.
핵심 내용
- 3.67B 파라미터의 2단계 H-Net은 SmolLM3-3B의 최종 평균 점수에 약 1조 토큰 분량으로 도달했고, SmolLM3는 약 11조 토큰이 들었습니다.
- 연산량을 맞춘 BPE(자주 붙어 나오는 글자를 묶는 토큰화) 트랜스포머는 같은 성능을 내는 데 1.28~2.06배 연산이 더 필요했습니다.
- 2025년 첫 H-Net은 다음 조각을 보고 나서야 경계를 정했고, 이를 고친 새 버전은 더 뜻 있는 단위로 자르고 한중일 문자도 제대로 나눕니다.
- 모델은 처음 보는 단어를 잘게 자르다가 반복되면 큰 덩어리로 묶는 식으로 추론 중에도 자르는 방식을 바꿉니다.
- DNA 모델링에서는 트랜스포머보다 연산 효율이 5.8~7.1배 높았고, 이미지는 수치 없이 정성적 결과만 내놓았습니다.
HN 반응
- 바이트가 '자연스러운' 단위인지를 두고, 비라틴 문자에선 바이트 배열이 제멋대로라는 반론과 표현력과 연산의 균형점이라는 반박이 맞섰습니다.
- BPE보다 디코딩이 느려 특정 분야에서만 쓸모 있을 것이라는 회의론에는, 글자 묶음도 스스로 배우고 여러 데이터에 통하는 범용성이 핵심이라는 반론이 나왔습니다.
문제는 바이트가 토큰보다 딱히 더 "자연스러운" 인코딩은 아니라는 거예요. 아니, 유니코드는 진짜 맙소사잖아요? BPE가 하는 일의 상당 부분은 문자를 바이트로 인코딩하려고 우리가 쓰는 제멋대로인 표준을 되돌리는 겁니다. 예를 들면 어떤 CJK 문자의 코드포인트를 나타내려고 쓰는 임의의 바이트 서너 개를 하나로 합치는 식이죠.
자연스러운 인코딩 방식은 얼마든지 많아요. 파형, 원핫 인코딩한 조음 특징, 모의 발성 기관을 위한 모터 프로그램, IPA, 인쇄된 글자의 비트맵(손글씨? 여러 글꼴을 평균 낸 것?), 글자를 그리는 SVG 프로그램, 표의 문자 설명 순서(Ideographic Description Sequence)로 덩치 큰 CJK 문자를 분해하기, 모든 유니코드 코드포인트를 똑같이 취급하기(바이트와 토큰의 중간쯤)...
제대로 된 조사는 없는 것 같습니다.
여기서 바이트는 토큰으로 쓰이는 게 아니고, 어떤 의미에서는 임의로 고른 선택입니다(그래도 좋은 선택이죠).
기사의 접근법은 더 큰 "토큰"을 쌓아 올릴 출발점으로 쪼갤 수 없는 기본 "원자"가 있기만 하면 됩니다(DNA 예시 참고).
원시 비트로 해도 되지만 의미가 없습니다. 바이트를 비트로 쪼갠다고 모델의 표현력이 늘지는 않는데 계산량만 8배가 되니까요(비트 수준에도 구조가 있기는 합니다. 예를 들어 ASCII에서는 대문자와 소문자 구분이 비트 하나로 표현됩니다. 하지만 모델이 동작하는 규모에서는 바이트만 보고도 그 정도는 쉽게 배웁니다).
이 접근법에서 (텍스트라면) 바이트가 표현력과 계산량 곡선 위의 거의 최적점입니다.
(생각해 볼 만한 다른 문제가 하나 있습니다. 바이트는 왜 8비트일까요?)
유니코드 바이트는 영어나 라틴 문자를 쓰는 다른 언어를 쓰는 게 아니라면 완전히 기괴합니다. 절대 최선의 선택이 아니에요.
그런데 사실은 맞아요. 바이트는 원시 데이터이고 토큰은 아키텍처가 고르는 거잖아요.
바이트는 원시 데이터가 아닙니다.
음성 발화, 손글씨, 키 입력이 원시 데이터입니다.
바이트는 그런 원시 의사소통 행위의 하류에 있고, 게다가 임의의 인코딩 방식의 하류이기도 하며, 그 밖의 여러 추상화 계층의 하류이기도 합니다. 같은 유니코드 코드포인트를 나타내는 바이트열이라도 사용자의 OS와 브라우저가 중국 본토, 대만, 일본 사람 기준으로 설정되어 있는지에 따라 다른 글리프로 표시되는 경우가 있어요.
라틴 문자 하나는 1바이트입니다. 화면에 똑같이 보이고 밑바탕의 음운 값도 같은 키릴 문자 하나는 2바이트고요. 그건 원시가 아닙니다.
멋지긴 한데, BPE와 대규모 데이터의 중복·반복을 활용하면서 NLP가 거쳐 온 최적화 흐름 전체에 역행합니다.
코딩 작업이나 영어에 이걸 적용하면 여러 글자짜리 패턴을 활용하고 디코딩도 훨씬 빠른 토크나이저보다 성능이 떨어질 거예요.
추측 디코딩(spec decode)이 흘러가는 방향을 생각하면(프런티어 모델에서 32토큰 spec-decode가 나오는 걸 봤습니다), 이게 쓸모 있으려면 아주 특정 분야에서 써야 한다고 봅니다. 예컨대 방대한 표 형식 데이터가 있겠지만, 그런 경우에는 이미 모든 게 구조화되어 있으니 그냥 polars/sql/arrow와 LLM을 쓰는 게 낫죠.
이 아키텍처의 핵심은 여러 글자짜리 패턴도 활용할 수 있다는 점이고, BPE와 달리 그 패턴이 하드코딩되어 있지 않다는 겁니다. 추측 디코딩도 그대로 쓸 수 있고요. 더 나은지 더 못한지는 직접 측정해 봐야 알 수 있는 문제입니다.
저자들의 전제는 이렇습니다.
바이트 트랜스포머처럼 계층 구조가 없는(등방성) 모델로 원시 바이트를 다루면 다운스트림 작업으로의 전이는 더 좋아지지만, 계산 비용이 엄청나게 듭니다.
토크나이저(사전 학습형이든 정규식 기반이든)를 쓰면 계산 효율은 크게 오르지만, 의미를 잃고 다운스트림 작업으로의 전이가 나빠질 수 있습니다.
마지막으로 H-Net을 쓰면 두 가지 장점을 모두 얻습니다. 모델이 하드코딩된 토크나이저나 따로 학습한 토크나이저보다 데이터를 더 잘 나누는 법을 스스로 배웁니다.
저자들은 이 접근법이 DNA 서열이나 이미지처럼 바로 쓸 수 있는 토크나이저가 많지 않은 다른 모달리티에서도 통한다는 것을 보여 줍니다.
이 아이디어의 핵심 전제는 얼마나 범용적이고 폭넓게 적용되느냐입니다. 이미지에서도 어떻게 동작하는지 예시를 보여 주고요.
공통 토큰화 패러다임이 생기면 모달리티마다 다른 전처리 방식을 하나로 통합하는 데 큰 걸음이 될 겁니다. 지능이 여러 모달리티에 걸쳐 잘 확장되려면 꽤 유용한 일이라고 생각해요.
와, 그 하스켈 퀵소트 토큰화 보니까 기분이 너무 좋네요.