요약
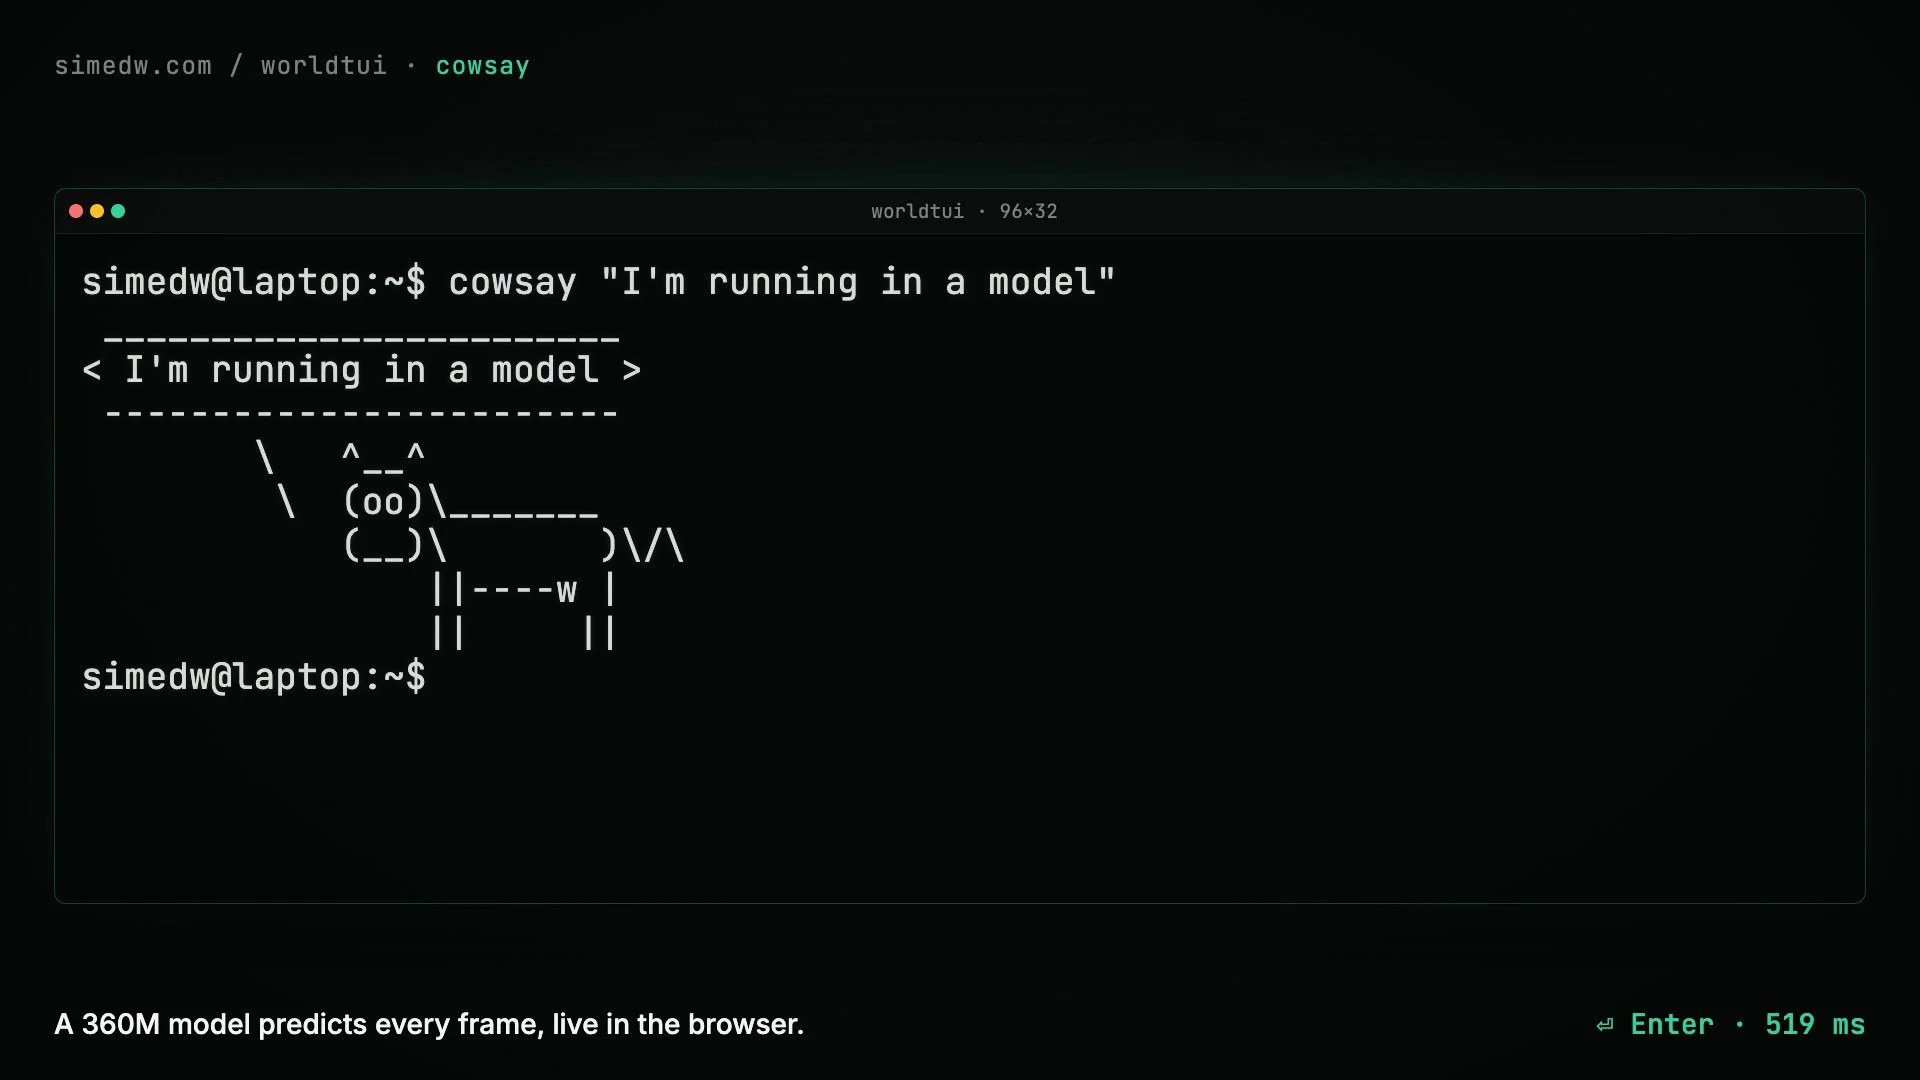
WorldTUI는 셸 없이 키 입력마다 다음 화면을 예측해 터미널을 흉내 내는 360M 모델입니다.
개발자 사이먼 에드워드손은 Genie 3 같은 영상 기반 월드 모델(입력에 따라 다음 상태를 예측하는 모델)을 문자 격자 크기로 줄여 실험했습니다. 이 모델은 파일을 만들고 vim, tmux, 스네이크 게임을 돌리며, 앞서 쓴 파일 내용도 꽤 자주 기억합니다.
왜 중요한가
- 규칙을 하나도 코드로 짜 넣지 않았는데도 어느 정도 일관된 가상 터미널이 유지됩니다.
- 208MB 모델이 WebGPU로 브라우저 안에서 돌아가 서버 없이 바로 써 볼 수 있습니다.
핵심 내용
- Qwen2.5-Coder-0.5B에서 쓰지 않는 임베딩을 잘라 360M으로 줄이고 int4로 양자화했습니다.
- 학습 데이터는 도커 컨테이너에서 bash, vim, python 등을 실제로 돌려 녹화한 세션 33만 6천 개입니다.
- 모델이 낸 틀린 화면을 실제 기록과 비교해 스스로 고치게 한 학습이 특히 효과가 컸습니다.
- 셸 명령 106개 중 80개를 정확히 맞혀, 예시만 준 Qwen3-0.6B(60개)보다 나았습니다.
- 다만
>>로 덧붙인 줄이cat에 안 보이는 등 믿을 만한 파일 시스템은 아닙니다.
HN 반응
- 여러 이용자가 2022년 ChatGPT에 터미널인 척하라고 시킨 데모를 떠올렸고, SSH 허니팟(공격자를 끌어들여 관찰하는 미끼 서버)으로 써 보자는 의견도 나왔습니다.
- 연구계의 '뉴럴 컴퓨터'를 작게 구현한 사례라는 평가에, 진짜와 구별되지 않으면 비밀번호를 빼내는 데 악용될 수 있다는 지적이 붙었습니다.
올려 주셔서 감사합니다. 궁금한 점이 있으면 기꺼이 답해 드리겠습니다!
실수를 바로잡는 능력이 정말 흥미롭네요. 이 부분을 더 실험해 보셨나요? 예를 들면 모델을 둘로 나눠서 하나는 생성만 하고 하나는 고치기만 하게 하는 식으로요.
결과에 차이가 있을지 궁금합니다. "자기 교정은 학습에서 가장 효과가 좋았던 변경 중 하나였다"는 관찰을 생각하면 꽤 의미 있을 수도 있겠어요.
이걸로 실제 파일 시스템에 파일을 만들 수도 있나요(모델이 할 수 있는 선에서)? 아니면 모델 혼자만의 작은 세계를 들여다보는 창일 뿐인가요?
모델의 컨텍스트 안에서만 존재합니다.
화면만 본다면 "********"를 비밀번호로 알아볼 수 있나요?
아주 좋은 질문입니다. 다만 학습할 때 실제 글자를 입력으로 받고 화면에 렌더링되는 결과로 *를 받기 때문에, 그 차이를 이해할 거라고 생각합니다.
훌륭한 질문이네요.
정말 멋지네요! 파인튜닝만으로 이게 된다니 놀랍습니다.
아주 비슷한 주제로, 저는 얼마 전에 "손실 압축 git(lossy git)"을 만들었습니다. 신경망을 학습시켜 코드를 저장하고, 체크아웃할 때 그 신경망이 코드를 다시 생성해 주는 방식입니다.
웹 데모: https://nicobrenner.github.io/lossy-git/demo.html
CLI 버전: https://nicobrenner.github.io/lossy-git/
웹 데모는 버전 관리도, 신경망 학습과 추론도 전부 브라우저 안에서 돌아갑니다. 이미지든 코드든 커밋하고 체크아웃할 수 있고, 가진 이미지를 붙여넣거나 "업로드"할 수도 있습니다. 서버로 가는 요청은 없고, 페이지를 새로고침하면 모든 게 지워집니다.
정말 멋진 프로젝트네요. 며칠 전에 모델에서 기억이 어떻게 인코딩되는지를 하나의 관점으로 풀어낸 블로그 글을 읽었는데, 관심 있으실 것 같아요. https://alexwang.ai/posts/associative-memory/
링크 감사합니다. 맞아요, 저도 그 글이 정말 좋았습니다. 마침 CLI 버전( https://nicobrenner.github.io/lossy-git/ )을 막 만든 참이었는데, 그 글에 영감을 받아 웹 버전을 만들었어요.
Alex Wang 글의 HN 토론은 여기 있습니다: https://news.ycombinator.com/item?id=50122878
그리고 프로젝트를 이렇게 자세하고 훌륭하게 정리해 주셔서 정말 감사합니다. 실수 교정 능력이 특히 궁금한데, 정말 흥미롭네요. 모델을 둘로 나눠서 하나는 생성하고 하나는 고치게 해 보셨나요? 결과에 차이가 있을지 궁금합니다. "학습에서 가장 효과가 좋았던 변경 중 하나였다"는 관찰을 생각하면 의미가 클 수도 있을 것 같아서요.
감사합니다! 관련 글을 모아 둡니다.
You could have invented transformers from memory - https://news.ycombinator.com/item?id=50122878 - 2026년 10월 (댓글 149개)
너무 웃기네요. 제 코드를 그 저장소에 커밋하면 체크아웃할 때 버그가 더 줄어들 것 같아요.
농담이시겠지만, 사실 꽤 좋은 연구 방향처럼 들려요. 코드베이스 두 개를 합치는 일이 신경망 git으로 병합하는 것만큼 쉬워진다면 뭘 할 수 있을지 상상해 보세요.
좋네요. 사실 데모가 이미 비슷한 걸 합니다. 모델을 두 개 학습시키거든요. 데이터를 저장하는 신경망 하나와, 그 데이터를 교정하도록 학습하는 분류기 하나입니다. 효과가 엄청나서, 이것만으로 충실도가 30%에서 90~100%까지 올라갑니다.
정말 흥미로운 아이디어입니다. "코드는 아예 들여다보지 않는" 미래가 정말 온다면, 이런 방식이 실제로 말이 될 수도 있겠네요.
미래요?
너무 엉뚱해서 마음에 들어요.
다만 사이트 글자가 모바일에서 너무 작게 보이고(모바일 화면이 따로 없는 듯해요) 저장소로 바로 가는 링크도 없다는 점은 알려 드리고 싶네요. 의도하신 거라면 물론 괜찮고요.
감사합니다. 제 휴대폰에서는 괜찮아 보이는데요. 어떤 브라우저와 OS를 쓰시나요?
저장소 링크는 글 맨 위에 있습니다: https://github.com/nicobrenner/lossy-git
이건 연구에서 "뉴럴 컴퓨터(Neural Computer)"라고 부르는 것의 소규모 구현입니다. UI 전체가 생성형이고 사용자 동작에 따라 움직이는 컴퓨터를 말합니다.
뉴럴 컴퓨터는 밑바탕에 운영체제나 애플리케이션이 있는 것처럼 느끼게 하지만, 실제로는 (사용자 입력) -> (예측된 픽셀 출력)을 되풀이하는 루프일 뿐입니다.
이론상으로는 완벽한 "뉴럴" 컴퓨터와 "진짜" 컴퓨터를 구별하는 게 불가능합니다. 생각해 보면 꽤 놀라운 얘기죠.
https://arxiv.org/abs/2604.06425
사람들한테 비밀번호를 입력하게 만들기엔 아주 좋은 방법이네요.
놀라운 일은 아닙니다. 뉴런 2개로 NAND 게이트를 모델링할 수 있고, NAND 게이트만으로 CPU를 만들 수 있으니까요.
https://nandgame.com/
CPU를 신경망으로 모델링하는 데 트랜스포머까지 필요하지도 않습니다. 문제는 학습입니다. 특히 셸 명령에서 출력까지 처음부터 끝까지 학습시키기가 아주 까다롭습니다. 이진적인 성질 때문에 그래디언트가 자주 뒤집히고, 메모리 출력이 다시 입력으로 되먹임되기 때문입니다(우리는 아직 RNN을 정확히 학습시키는 법을 모릅니다).
LLM이라면 호출이 끝날 때마다 KV 캐시를 잊게 하고, 대신 상태를 컨텍스트로 주입해 주도록 해야 합니다. 그러면 모델이 터미널 명령 끝에 그 상태도 함께 출력하게 되고, 그걸로 학습시키는 겁니다. 이렇게 하면 파라미터가 충분해서 해상도가 확보되고 명령 전처리(예컨대 한 줄로 이어 붙인 복잡한 셸 명령을 쪼개는 것)까지 갖춘다면, 가능한 모든 입력에 대해 정확한 출력과 상태 변화를 보장할 수 있습니다. 결국 효율적인 RNN 대신 훨씬 넓은 일종의 조회 테이블을 얻게 되는 셈이죠.
흥미롭네요. 그 모델과 파인튜닝한 버전을 비교하면 어떨지 물어보려 했는데, 작성자가 벤치마크를 내놨더군요. 파인튜닝으로 기억력이 그렇게 크게 좋아졌다는 게 신기합니다. 그럴 줄은 몰랐어요.
그런데 다시 생각해 보니, 저도 사람으로서 기억력을 예전에 가능하다고 여기던 것 이상으로 파인튜닝해 본 경험이 있네요!
제가 제일 좋아하는 농담이 떠오릅니다.
실례지만 카네기홀에 어떻게 가나요?
—연습이죠, 선생... 연습이요...
아직 본격적으로 테스트하지는 않았지만, 더 큰 모델은 기억력도 더 좋아집니다.
자세히 말씀해 주세요.
제가 질문받으신 분은 아니지만, 기억의 궁전 같은 기법이 있어서 많은 사람이 카드 한 벌을 통째로 외우는 것 같은 인상적인 기억 묘기를 부릴 수 있습니다.
조슈아 포어는 사람들이 어떻게 그런 암기 기술을 쓰는지 파헤치는 기사를 썼는데, 결국 거의 누구나 할 수 있다는 결론을 내렸고, 1년 연습한 끝에 실제로 미국 기억력 대회에서 우승했습니다. 이 주제로 기사를 여러 편 쓰고 책도 낸 걸로 아는데, 제가 처음 읽은 게 어느 쪽이었는지는 잘 모르겠네요.
저도요, 말씀해 주세요. 궁금합니다.
ChatGPT로 본 데모 중 처음으로 정말 멋지다고 느낀 것 하나가, 작성자가 AI에게 "터미널인 척해 줘"라고 시킨 글이었어요. 그러고는
cd .fbi,ls files,cat files/confidential.txt같은 명령을 실행했죠. 아주 재밌는 데모였습니다. 이 터미널로도 비슷한 걸 해 보고 싶네요.그게 제일 대단했던 점은, lynx 브라우저를 "설치"해서 이 터미널 안에서 다른 우주의 웹을 "탐색"할 수 있었다는 거예요. 그때는 챗봇이니 LLM이니 하는 게 아직 아주 새로웠고, "그냥 다음 토큰 예측"으로 그런 동작이 가능하다는 게 말도 안 되고 불가능해 보였죠! 예를 들어 이 터미널에서 파일을 "만들면" 저장되고, 웹페이지를 내려받는 식이었으니까요. 가드레일이 들어가면서 그 터미널이 사라진 건 정말 아쉬웠어요.
그건 GPT-3.5 시절 맨 처음이었던 걸로 기억합니다.
저는 늘 그걸 열린 SSH 서버 뒤에 "가짜" 허니팟처럼 붙여 두고, 공격자나 스크립트 키디가 뭘 하는지 보고 싶었어요. 하지만 지금쯤이면 벌써 누군가 해 봤겠죠...
기사에서 그 얘기를 분명히 언급하고 링크도 걸어 뒀습니다: https://www.engraved.blog/building-a-virtual-machine-inside/