요약
Furifont는 글꼴 안에 후리가나를 그려 넣어, 자바스크립트 없이도 한자 위에 읽는 법을 띄웁니다.
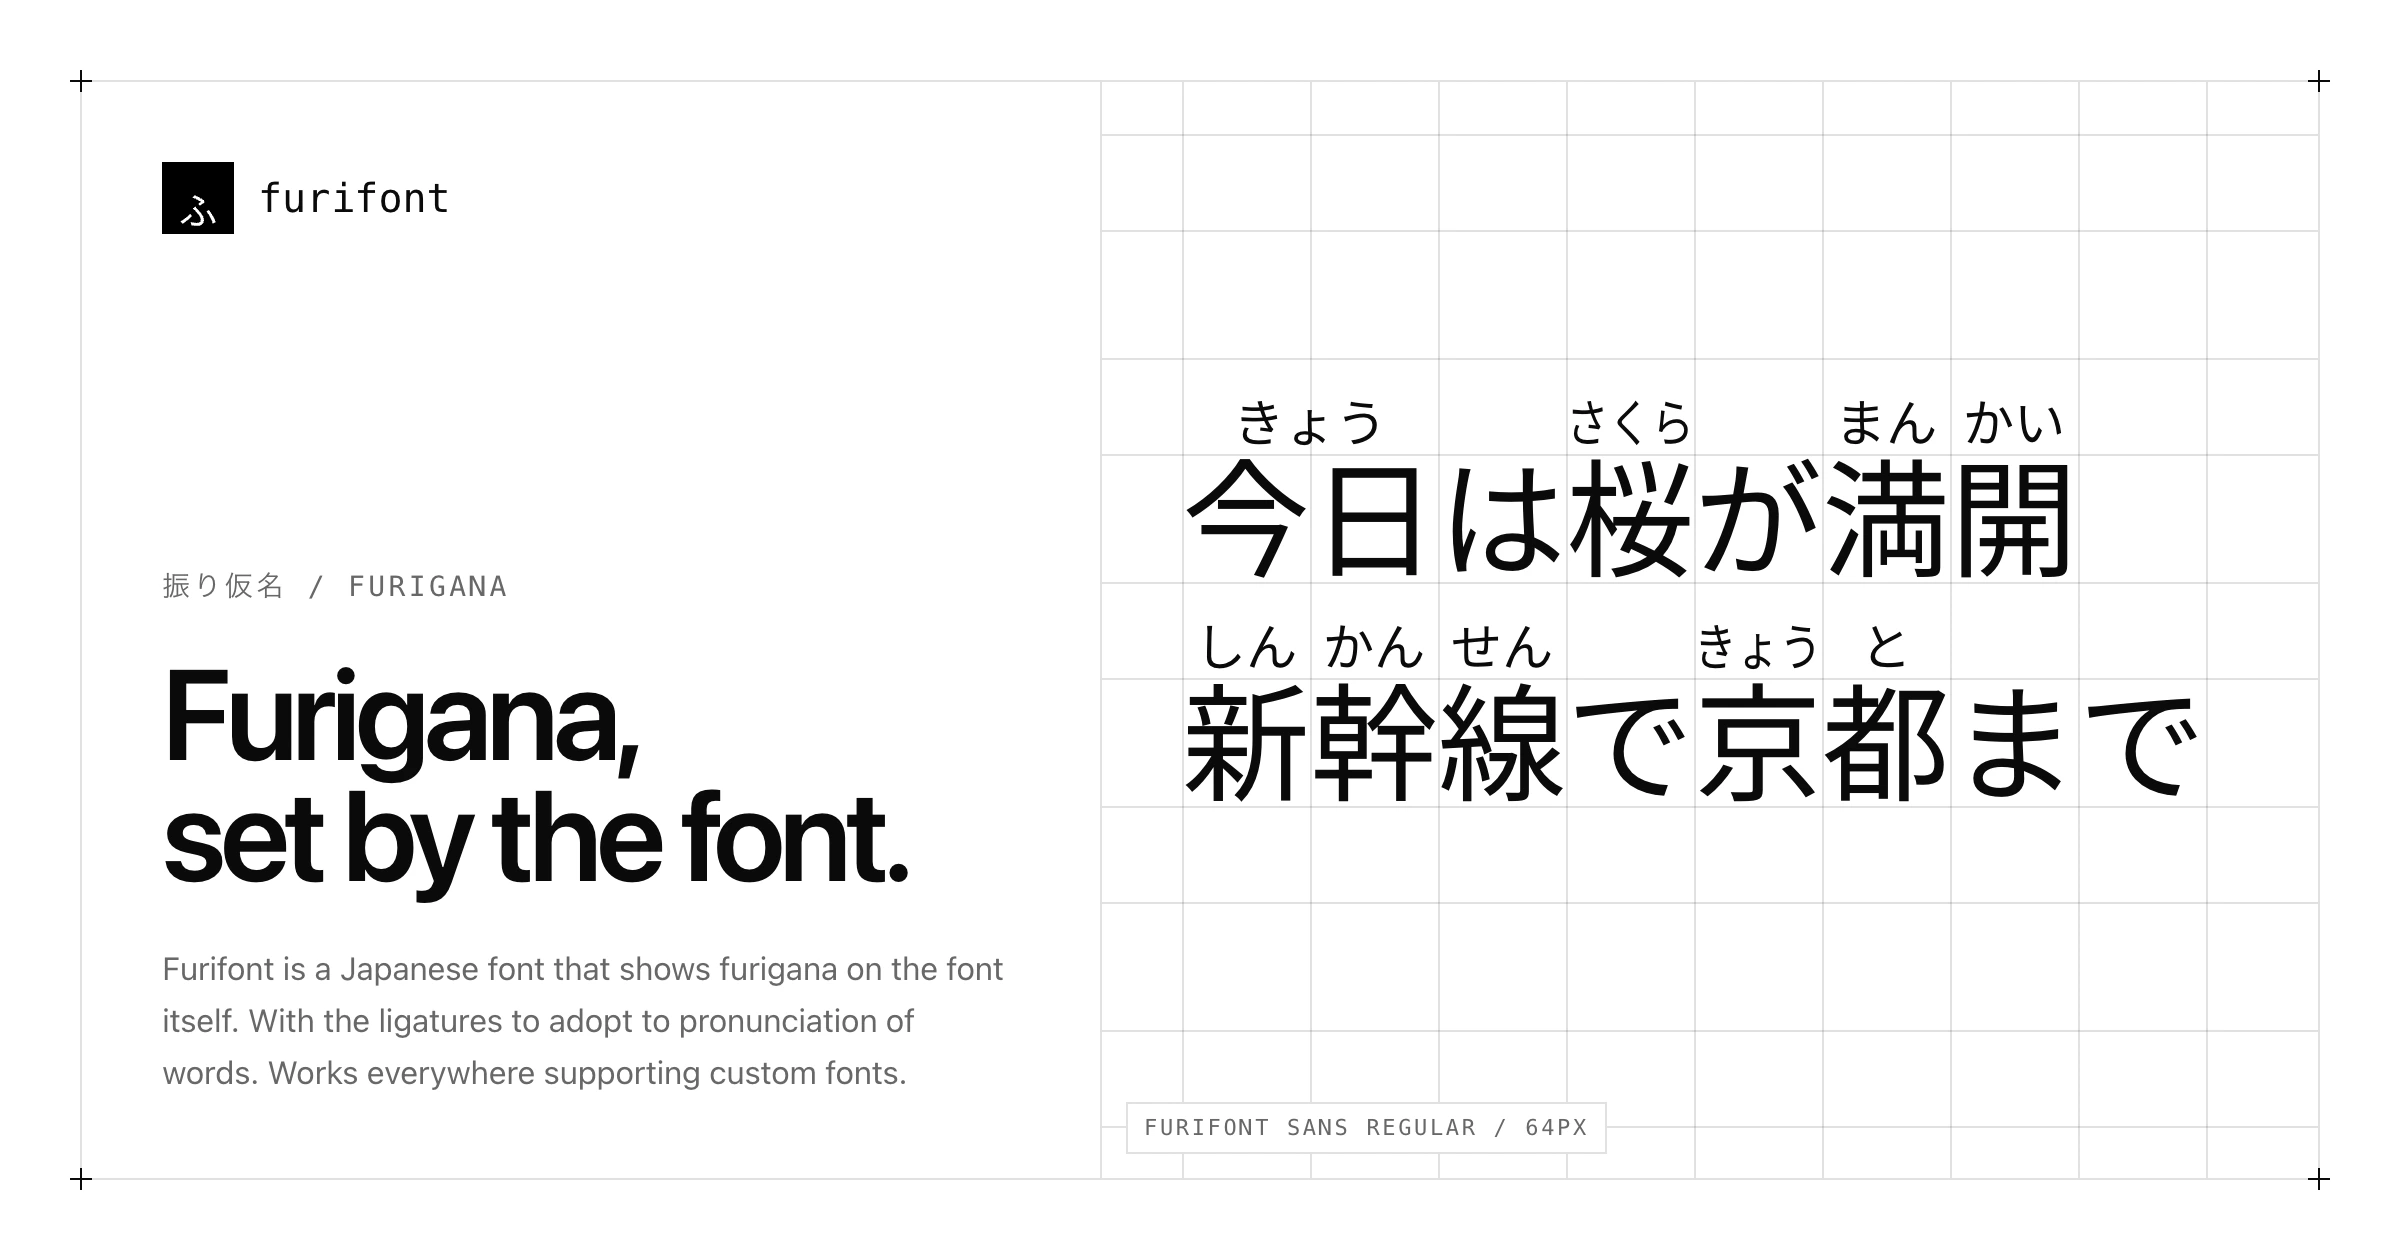
후리가나(일본어 한자 위에 작게 다는 가나 읽기 표시)를 글꼴 파일 자체에 담은 일본어 글꼴이 공개됐습니다. Source Han Sans와 Source Han Serif를 바탕으로 만들었고, 사용자 지정 글꼴을 쓸 수 있는 곳이면 어디서나 작동합니다.
왜 중요한가
- 문서의 텍스트나 HTML은 그대로 두고 글꼴만 바꿔서 한자 읽기를 보여 줍니다.
- 가나는 읽지만 한자를 아직 다 익히지 못한 학습자가 일반 웹페이지를 읽을 때 기댈 수 있습니다.
- 합자(여러 글자를 한 글자 모양으로 바꿔 그리는 글꼴 기능)를 읽기 표시에 활용한 드문 사례입니다.
핵심 내용
- 단어마다 합자를 하나씩 두어, 今日를 위에 きょう가 붙은 한 글자 모양으로 바꿔 그립니다.
- 이어진 한자를 수천 개의 상용 단어 목록과 비교하며, 日本보다 日本語처럼 가장 긴 단어부터 맞춥니다.
- 大人気처럼 읽기가 갈리는 단어나 읽기가 확실하지 않은 한 글자 한자에는 후리가나를 달지 않습니다.
- 다른 읽기를 원하면 첫 한자 뒤에 보이지 않는 이체자 선택자를 넣어 몇 번째 읽기를 쓸지 고릅니다.
- 히라가나판과 로마자판을 고딕·명조로 내려받을 수 있고, 북마클릿이나 유저스크립트로 아무 사이트에나 켤 수 있습니다.
HN 반응
- 한자 읽기는 문맥에 크게 좌우되어 글꼴만으로는 정확할 수 없다는 지적이 이어졌고, 통계 기반 분석기도 4%가량은 틀린다는 보충이 나왔습니다.
- 일본어 원어민 이용자는 소개 페이지의 合字에 字의 읽기만 붙는 오류를 짚었고, 줄바꿈으로 大学이 나뉘면 읽기가 틀어진다는 경험담도 나왔습니다.
폰트 합자(ligature)를 이렇게 "쓸모 있게" 악용한 건 드문 경우라 멋진 프로젝트라고 생각합니다. 하지만 동시에 아무도 실제로 쓰면 안 되는 끔찍한 발상이기도 합니다. 일본어 한자의 읽기는 악명 높을 만큼 모호하고 문맥에 따라 달라지기 때문입니다. 가장 전형적인 한자 하나만 해도 인명에 쓰이는 읽기와 문맥에 따른 미묘한 발음 변화를 빼고도 읽기가 두 가지입니다. 어떤 한자는 인명에 쓰이는 읽기를 빼고도 읽기가 여섯 가지나 됩니다. LLM 하나를 통째로 폰트에 욱여넣을 수 있다면 모를까, 폰트가 이걸 제대로 해내는 건 불가능합니다.
참고로 이 문제는 구글 번역이 내놓는 로마자 발음 표기조차 자주 틀리거나 자기네 음성 합성(TTS)과 어긋날 만큼 어려운 문제입니다.
동의합니다. 오히려 실상은 더 심각합니다. 읽기가 여섯 가지인 한자를 말씀하셨는데, 서른 개가 넘는 한자도 있습니다.
https://en.wiktionary.org/wiki/%E7%94%9F
그리고 뒤에 오는 말을 보고 어떤 읽기가 맞는지 대개는 알아낼 수 있지만, 그렇지 못한 경우도 많습니다. 단독으로 쓰인 今日는 문맥과 의도에 따라 "konnichi", "kyou", "konjitsu" 중 무엇으로든 읽힐 수 있습니다.
그건 이미 한 번 해낸 사람이 있어요 ;)
https://fuglede.github.io/llama.ttf/
조건부 랜덤 필드(CRF)만으로도 꽤 잘 해낼 수 있다고 봅니다.
꽤 잘 한다는 게, 제 기억이 맞다면 CRF를 쓰는 MeCab의 결과가 96% 정도 맞는다는 얘기입니다. 그런데 한자 단어의 4%가 틀리면 한 페이지에 후리가나가 여러 개 틀린다는 뜻이거든요.
그래도 데모는 정말 멋집니다!
정말 멋진 폰트네요! 저는 일본어 원어민인데, 후리가나를 폰트만으로 구현했다는 게 무척 인상적입니다.
사소한 점 하나만 짚자면, 페이지 일본어판의 "Ligatures do the work" 섹션에서 合字 자체에는 字 위에 じ만 붙어 있고 合에는 읽기가 없습니다. ごうじ가 되어야 합니다. 아마 合字가 사전에 없어서 한자 한 글자씩 처리하는 방식으로 넘어갔고, 合은 읽기가 여러 개라 건너뛴 것 같습니다.
읽기가 문맥에 크게 좌우되고 그 문맥을 쉽게 추론할 수 없으니, 후리가나 자동 생성은 믿을 만한 수준이 되기 어렵습니다. 다만 읽기가 서툰 사람들에게는 도움이 되리라 생각합니다.
셰이핑 엔진 안에서 LLM을 돌릴 수도 있으니, 더 고급 분절·음역 알고리즘을 쓰면 되지 않을까요? https://fuglede.github.io/llama.ttf/
암묵적인 정보에 따라 달라질 수도 있어요. 예를 들어 方는 방향을 말하는지 사람을 말하는지에 따라 hou가 되기도 하고 kata가 되기도 하죠. 그 정보가 앞에 있을 수도, 뒤에 있을 수도, 옆에 있는 이미지에 있을 수도 있고요.
"당신네 과학자들은 할 수 있느냐 없느냐에만 정신이 팔려서, 해야 하느냐 말아야 하느냐는 생각해 볼 겨를이 없었군."
정말 멋집니다. 다만 단어가 줄바꿈에서 갈라지면 발음이 틀리게 나오는 점은 아쉽습니다(저는 大学가 두 줄로 갈라지면서 후리가나가 엉뚱하게 바뀌었습니다).
이 웹사이트에서 한자가 중국어 자형으로 보이네요. HTML에 언어 표기 같은 게 필요할 수도 있겠습니다. https://i.postimg.cc/NGTvHP4x/Screenshot-2026-10-17-at-12-00-04-PM.png
정말 좋네요. 저는 4~6주쯤 공부해서 이제 히라가나와 가타카나는 완전히 읽을 수 있게 됐는데, 실생활에서 뭔가 읽으려 할 때마다 아직 배워야 할 한자가 얼마나 많은지 현실을 마주하게 되네요 ㅋㅋ
놀랍네요. 저는 TrueType/오픈 폰트 사양이 얼마나 쓸모 있는지 볼 때마다 감탄합니다. 그 유연함은 과소평가된 공학적 천재성의 결작이라고 생각해요.
기능 자체는 대단한데 그걸 실제로 써먹는 건 wat인 경우라고 할 수 있겠죠.
https://www.destroyallsoftware.com/talks/wat
폰트는 튜링 완전하니까 [0] 이게 가능하다는 게 놀라운 일은 아닙니다. 튜링 완전성은 천재성보다 우연의 산물인 경우가 많죠 [1].
[0] https://litherum.blogspot.com/2019/03/addition-font.html
[1] https://en.wikipedia.org/wiki/Turing_completeness#Unintentional_Turing_completeness
인간의 언어가 튜링 완전하다고 하니 말이 되네요. 언어를 충실하게 표현하려는 것이라면 뭐든 결국 그런 특성을 갖게 될 테니까요.
인간의 언어는 형식 언어가 아니니 그건 범주 오류입니다.
지금 맥락에서 예를 들면, 한자 단어의 통상적인 읽기가 항상 명확하게 정해져 있는 것도 아니고, 한자 나열을 단어로 나누는 방법도 마찬가지로 명확하지 않습니다.
그래도 형식 언어처럼 쓰이는 경우가 많잖아요.
아닌데요? https://en.wikipedia.org/wiki/Formal_language#Definition
인간이 필요할 때 자연어를 형식 언어처럼 끌어다 쓰지 않는다고 주장하면서, 영어로 엄밀하게 쓴 형식 언어의 정의를 보여 주시다니 흥미로운 수를 두셨네요.
"형식 언어"는 그런 뜻이 아닙니다. 형식적인 정의를 서술하는 데 영어가 쓰였다고 해서 영어가 형식 언어가 되는 건 아닙니다.
저는 영어가 형식 언어라고 한 적 없어요. 인간이 영어를 형식 언어처럼 끌어다 쓴다고 했죠.
비트맵 폰트는 튜링 완전하지 않습니다. TrueType이 임의의 가상 머신을 갖추고 만들어졌다는 건 정신 나간 일입니다. 구현을 터무니없이 복잡하게 만들고, 보안상 엄청난 부담이 되죠. 그 VM의 목적은 "인간의 언어를 충실하게 표현"하는 게 아니라, 힌팅으로 여러 해상도에서 폰트가 조금 더 보기 좋게 표시되게 하는 것이었습니다. 힌팅에 꼭 완전한 VM이 필요한 것도 아닌데, 누군가가 엔지니어들에게 너무 재미를 보게 놔둔 겁니다.
그런데도 인류의 모든 문자 언어와 그 합자, 변형 등을 실제로 다 매핑하려면 이 정도 복잡성이 필요해 보여요. 그러니 선택지는 둘입니다. 어디까지를 정당한 언어로 볼지 선을 긋거나, 모든 언어를 담을 만큼 충분히 복잡한 기계를 만들거나요. 결국 컴퓨터 시스템에 지식을 얼마나 담아내고 싶은지가 트레이드오프겠죠.
유니코드는 TrueType과 별개이고 아무 관련이 없습니다. 유니코드는 해석하는 데 가상 머신이 필요 없습니다. 유니코드와 비트맵 폰트만으로도 언어와 그 변형을 얼마든지 표현할 수 있습니다.
합자를 원하지 않는다면요.
합자를 구현하는 유일한 방법이 가상 머신이라고 정말 믿으시나요? 5초 생각해서 대충 쓴 엉터리 의사코드지만, 이게 그렇게 복잡한 일은 아니잖아요.
그러면 92%쯤 온 겁니다. 그걸 몇십 번 더 반복해서 97%, 98%, 99%까지 끌어올리다 보면 결국 OpenType을 다시 쓰게 될 거예요.
그 몇십 가지 경우를 얼버무리고 넘어가지 말고 자세히 설명해 주시겠어요? 폰트 포맷에 VM을 집어넣는 건 근본적으로 터무니없는 발상이고, 그러려면 반드시 제대로 된 근거가 있어야 합니다. 물론 우리 업계가 임의 코드 실행 익스플로잇을 가능하게 하는 건 뭐든 좋아한다는 건 알지만요.