요약
30년 동안 쌓인 체스 엔진 기법을 1996년 Pentium Pro에 옮기면 카스파로프를 이길 만큼 강해집니다.
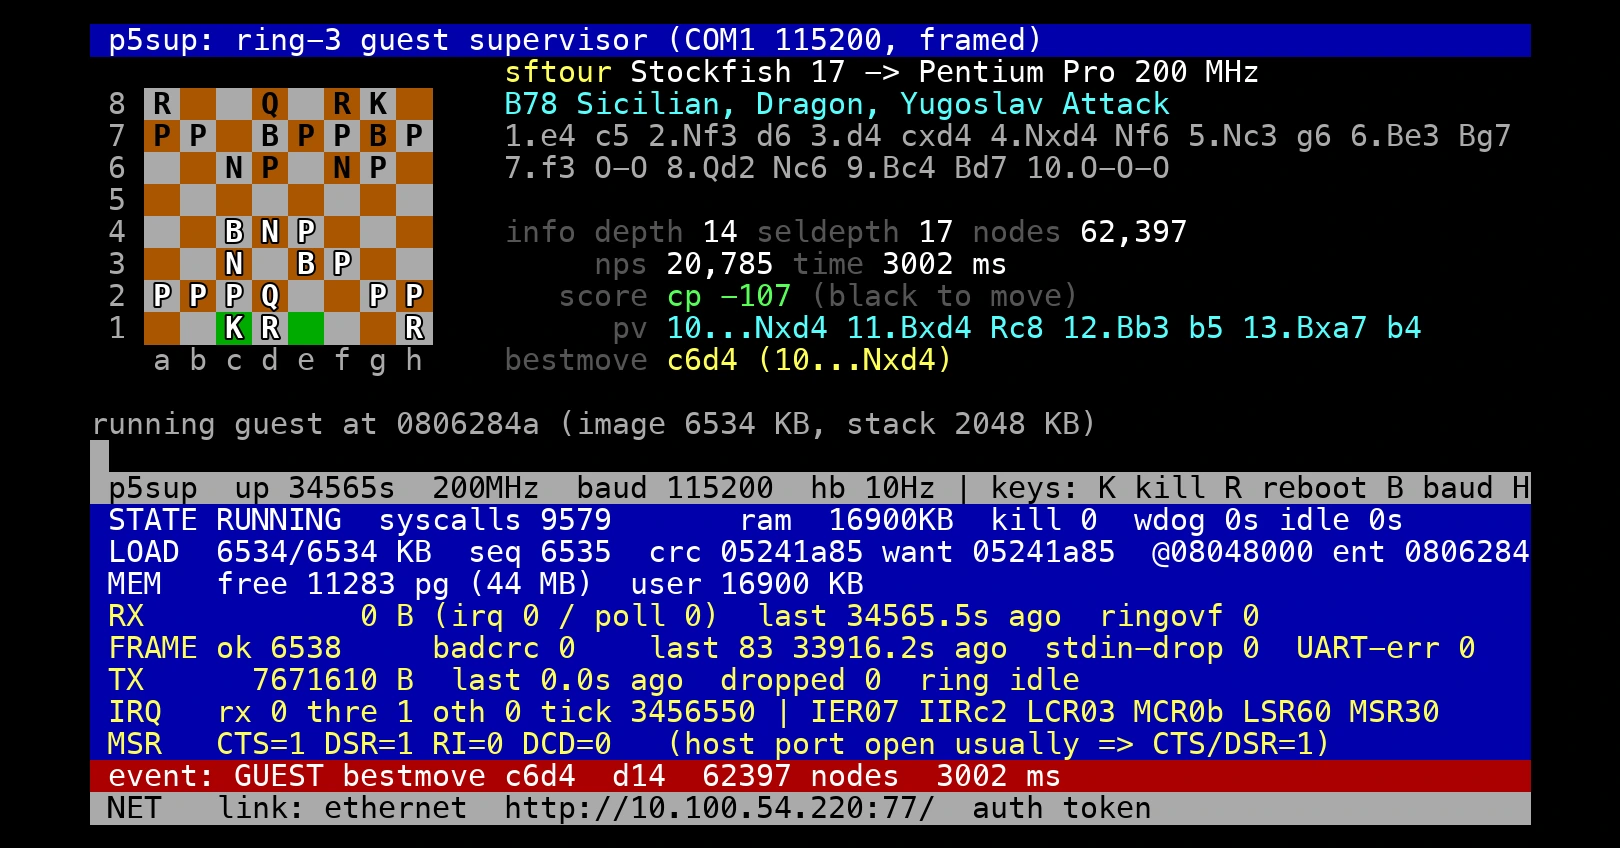
연구자 니컬러스 칼리니가 200MHz Pentium Pro 컴퓨터로 직접 해 본 실험입니다. 당시 지금의 지식이 있었다면 IBM의 전용 기계 Deep Blue 없이 평범한 PC로도 카스파로프를 이길 수 있었는지 알아봤습니다.
왜 중요한가
- 1996년 이후 오른 엔진 실력(+1,335점) 가운데 +720점이 하드웨어가 아니라 프로그래밍 발전에서 나왔다는 결과입니다.
- 저자는 AI 전반에서도 소프트웨어 발전이 하드웨어 확장보다 더 큰 몫을 할 수 있다고 봤습니다.
핵심 내용
- Stockfish 17을 32비트, 단일 스레드, 64MB 메모리에 맞게 옮기자 한 수에 10초씩 줄 때 Elo(실력 점수) 약 3109가 나왔습니다.
- 저자는 정식 대국 시간으로 환산하면 약 3300점이라며, 2800점에 못 미치는 카스파로프에게 10판 중 9점쯤 낼 것으로 봤습니다.
- 1996년판 Crafty 11.13에 최신 기법을 하나씩 더하자 같은 조건에서 2383점이 2974점으로 올랐습니다.
- 가장 큰 효과는 Stockfish를 교사로 다시 학습한 NNUE(신경망 평가 함수)와 매개변수 자동 튜닝에서 나왔습니다.
- 코드는 주로 LLM이 짰고, 실제 기계를 인터넷에 연결해 독자가 직접 대국해 볼 수 있게 했습니다.
HN 반응
- 엔진끼리 매긴 Elo는 빠른 시간제한 대국 기준이라 사람의 정식 대국 실력과 바로 비교하기 어렵다는 지적이 여럿 나왔습니다.
- 한 체스 실력자는 엔진의 얕은 수읽기를 노려 쉽게 이겼다고 했고, 더 강하다는 이용자는 평범하게 두다가 졌다고 전했습니다.
글이 말하려는 핵심은 맞습니다. 현대 체스 엔진이 더 강한 건 대부분 평가 함수와 탐색 등이 개선된 덕이지 하드웨어 덕이 아닙니다. 하지만 카스파로프가 90년대 하드웨어에서 돌아가는 엔진에 졌을 거라는 말은 다들 생각하는 것만큼 분명하게 참은 아닙니다. 현대 엔진의 평가 함수와 탐색 알고리즘은 깊이를 두고 하는 절충 방식이 매우 다르고, 연산 자원이 충분하지 않으면 눈에 띄는 약점을 드러내는데, 카스파로프와 그의 팀이라면 그 약점을 파고들었을 가능성이 큽니다.
저는 USCF 1950에 불릿 2300+ 정도 되는 준전문가 수준인데도, 이기는 수순을 찾는 건 어렵지 않았습니다. https://nicholas.carlini.com/writing/2026/algorithmic-improvements-chess.html?game=SM1jO0bP
그리고 엔진 Elo 3000이라는 숫자는 직접 비교 대상으로 삼기에 그리 좋지 않습니다. 엔진 Elo는 사람과 엔진을 비교하라고 있는 게 아니라 엔진끼리 비교하라고 있는 겁니다.
현대 엔진이 쓰는 지식 기반 기법 중 상당수는 깊은 탐색이나 다른 조건이 필요해서 옛 하드웨어에서는 통하지 않았습니다. 딥 블루는 90년대에는 무식하게 밀어붙이는 쪽이 더 잘 통했기 때문에 많은 부분을 브루트 포스로 처리하도록 설계됐습니다. 체스 엔진 역사에서는 온갖 시도가 버려졌다가 다시 시도되곤 했습니다. 체스 엔진 개발(그리고 AI 전반)은 순환적입니다. 하드웨어가 바뀌고 발전하면 옛 아이디어가 다시 돌아와 재시도됩니다. 지난 시대의 개발자들은 우리가 쳐주는 것보다 훨씬 똑똑하고 아는 것도 많았습니다. 심지어 체커와 체스의 아주 초창기 엔진 중에는 (일종의) 신경망도 있었어요.
또 하나의 참고 사례로, 저는 그보다 조금 더 강한 편인데도 '평범한' 체스로 붙었을 때 적어도 몇 판 동안은 여유 있게 졌습니다. 한 판은 비겼어야 했는데 말이죠. 수평선 효과를 노리려던 발상이 맞았다고 생각해요. 11... h6??은 웃기네요.
흥미로운 점은, 보통 컴퓨터를 상대로는 전술적으로 뒤엉킨 국면으로 가는 게 가장 하지 말아야 할 일이라는 겁니다. 90년대 컴퓨터여도 마찬가지고요. 저는 조용한 국면에서 헛발질할 거라고 짐작했는데 완전히 틀렸더군요!
이상하게도 이 엔진과 두면 깊이가 제한된 컴퓨터를 상대할 때보다 훨씬 '사람 같은' 느낌이 납니다. 뭐가 다른 건지는 잘 모르겠어요. 연습용으로 이 환경을 그대로 재현해 보고 싶네요.
카스파로프의 책을 읽어 보셨다면 거기에 그 이야기가 나옵니다. 본인 말로는, 딥 블루가 예측하지 못하는 수순을 찾아내서 딥 블루를 완전히 몰아붙였다고 해요. 그런데 IBM이 대국 사이에 시스템을 패치했고, 그는 그걸 비신사적이라고 여겼습니다.
그러니까, 이전 대국에서 배우는 게 비신사적이라는 건가요? 그러면 정말 많은 대국이 무효가 되겠는데요...
대국 조건에는 IBM이 사람을 시켜 컴퓨터 프로그램을 돕게 하지 않는다는 취지의 내용이 있었습니다. 그런데 IBM은 대국 사이에 컴퓨터의 오프닝 북을 수정해서, 카스파로프가 앞서 둔 수순들을 더 깊이 파고들게 했습니다. 사람의 도움을 금지한다는 게 한 판 안에서 두는 수에만 해당하는지, 대국 사이에 컴퓨터를 수정하는 것까지 포함하는지는 분명하지 않았어요.
그 일이 6국에서 벌어졌습니다. 컴퓨터가 나이트를 폰과 맞바꾸는 희생으로 흑의 수비를 무너뜨렸는데, 카스파로프는 컴퓨터가 기물 손실 너머까지 깊이 내다보지 못하니 그런 수는 두지 않을 거라고 생각했습니다. 하지만 IBM이 그 수를 오프닝 북에 넣어 두었기 때문에 컴퓨터는 그렇게 둘 줄 알았던 거죠. 이 논란은 2국에서 카스파로프가 IBM의 부정행위를 의심했던 논란과는 별개입니다. 2국에서는 카스파로프가 컴퓨터가 물질적 이득을 챙길 거라고 예상했는데, 컴퓨터가 포지션 중심으로 두었고, 카스파로프는 사람이 개입하지 않고서는 컴퓨터가 그 수순을 찾지 못했을 거라고 생각했습니다.
https://en.wikipedia.org/wiki/Deep_Blue_versus_Garry_Kasparov https://en.wikipedia.org/wiki/Deep_Blue_versus_Kasparov,_1997,_Game_6
극단적인 경우를 생각해 보면, 대국 중간 휴식 시간에 다음 수순을 정확히 하드코딩해 넣는 것도 가능할 겁니다.
그쯤 되면 엔진과 두는 게 아니라, 얇게 위장한 프록시를 거쳐 그 뒤에 있는 사람들과 두는 셈이 되는 선이 있습니다.
이번 경우에 그 선을 넘었다고는 생각하지 않습니다. 하지만 혼란을 피하려면, 대회 기간 동안 엔진을 그대로 고정해 두기를 기대하는 게 무리한 일은 아니라고 봅니다.
+1, 대국 사이에 시스템을 패치하는 건 비신사적으로 보입니다.
저는 체스란 원래 한 사람과 다른 사람이 겨루는 것이고, 시리즈 도중에 팀이 협업하는 건 비신사적이라고 늘 생각했습니다. 딥 블루에 프로그래머들과 다른 마스터들이 붙어서 변경을 돕고 있었다면, 사실상 상대편인 기계를 적극적으로 돕는 셈이니 옳지 않아 보입니다.
사실 예전에는 최상위 수준의 대국에서도 중단된 대국(adjournment) 동안 팀과 상의하는 게 흔한 일이었습니다. ( https://chess.stackexchange.com/questions/34614/is-acceptable-to-consult-with-your-team-during-a-match-break )
우리나라의 유명한 축구 선수가 이런 말을 한 적이 있습니다. 스포츠는 전쟁과 같아서, 이기기만 한다면 뭐든 허용된다고요.
전쟁에도 스포츠에도 규칙이 있습니다. 예를 들어 축구 경기에서 이기려고 상대 선수를 죽이면 안 되잖아요.
왜요?
딥 블루와의 대국으로 홍보됐으니까요. SaaS나 자동 온라인 업데이트가 없던 시절이라, 이건 다른 소프트웨어 제품처럼 변하지 않는 하나의 시스템을 뜻한다고 받아들여졌을 겁니다. 대국 도중에 바꾼다면 그건 딥 블루 + IBM 프로그래머 팀과의 대국이 됩니다.
딥 블루 + IBM 프로그래머 + 이들을 돕던 체스 그랜드마스터 팀이었죠. 일반적으로 저는 카스파로프의 주장을 그렇게까지 믿어 주지는 않았을 겁니다. 다만 대국이 끝나자마자 IBM이 그 기계를 곧바로 해체해 버렸고, 그게 너무나 켕기는 게 있어 보였다는 점이 달라요. 그 기계의 역사적 가치를 생각하면 더더욱요.
정상적인 세상이라면 IBM 건물이든 스미스소니언이든 어디든 가서 그 하드웨어와 한 판 둘 수 있어야 합니다.
참고로 체스계에서는 카스파로프를 대체로 믿을 만한 화자로 보지 않습니다. 특히 자기 명성과 자존심이 걸려 있을 때는요. 그가 하는 말과 행동은 전부 자기 이익을 챙기는 쪽입니다.
그렇다고 그의 대단한 노력과, 역대 최고 선수 중 한 명이라는 위상을 깎아내리려는 건 전혀 아닙니다.
맞습니다. 레이팅 풀 자체가 완전히 다르다는 점은 차치하고도, 체스 엔진의 Elo는 더 빠른 제한 시간이나 불균형한 오프닝을 기준으로 매겨져서 FIDE 레이팅의 클래시컬 체스 실력으로는 잘 환산되지 않습니다.
글쓴이가 끝부분에서 컴퓨터 레이팅에 관한 단서를 달아 놓기는 했지만, 제 생각에는 그래도 그 차이를 축소하는 데 너무 나아갔습니다.
아주 곁다리 이야기이긴 한데, 요즘 영상 압축이 믿기지 않을 만큼 좋아져서, 과거로 AV1이나 HEVC 같은 걸 가지고 돌아간다면 ISDN 회선으로도 240p 영상 스트리밍을 쓸 만하게 할 수 있지 않았을까 하는 생각을 자주 합니다.
아슬아슬하게 들어맞겠지만 그래도 가능한 범위라고 봅니다. 영상을 줄이는 기술이 워낙 좋아져서 제게는 마법처럼 느껴져요. 물론 90년대에 그걸 인코딩하거나 디코딩할 만큼 강력한 컴퓨터가 있었는지는 모르겠지만요.
몇 해 전에 "8088 Domination"이 1981년 오리지널 IBM 개인용 컴퓨터에서 풀 모션 비디오를 재생해 보였습니다.
https://trixter.oldskool.org/2014/06/19/8088-domination-post-mortem-part-1/
알고 보니 그 영상은 오리지널 PC의 디스플레이 대역폭만으로 재생할 수 있게 인코딩된 것이었습니다. 다만 그렇게 인코딩하려면 합리적인 시간 안에 끝내기 위해 현대 컴퓨터가 필요했습니다.
아, Amiga Juggler와 똑같네요. VAX에서 압축해서 Amiga에서 재생했죠. 완전한 레이 트레이싱이었지만, 트레이싱과 압축은 미니컴퓨터가 했습니다.
이 설명에서는 원래의 레이트레이싱과 압축이 Amiga에서 이루어졌다고 합니다. http://www.etwright.org/cghist/juggler.html
이제는 옛날 방식이죠. Claude가 이런 걸 만들어 냈습니다. https://os8088.com/spotlight/video-player/
16MHz 286 Packard Bell Victory에서 전체 화면 30FPS로 돌아가는 모습입니다. https://www.youtube.com/watch?v=fEJPLT_rSRY
글쎄요, 그건 CPU가 적어도 6배 빠르고 VGA와 사운드 카드까지 있는 환경이잖아요. 8088 Domination은 PC 스피커로 소리를 재생해야 하는데, 그게 CPU를 많이 먹습니다.
곁다리의 곁다리 이야기인데, 터보 부호와 LDPC는 불안정한 통신 링크로 데이터를 보낼 때 목표 오류율에 맞춰 최적의 중복도를 얻는 알고리즘입니다. 현대 무선 데이터 전송 상당수의 밑바탕이고, 섀넌 이후로 가능하다는 건 알려져 있었지만 실제로 어떻게 하는지는 아무도 알아내지 못했죠. 90년대에 이것이 발명됐을 때 다들 처음에는 믿지 못하고 반응했다고 합니다!
그 설명은... 제가 보기엔 틀린 것 같은데요.
리드-솔로몬 코드는 품질은 더 높지만 훨씬 오래된 것이고 행렬을 풀어야 합니다(LU 분해에 이것저것이 붙는, 사실상 행렬 역행렬을 구하는 것과 같은 작업이죠).
터보 코드/LDPC는 제가 알기로 O(n)이고, 리드-솔로몬은 행렬이 어떻게 나오든 O(n^2.5)쯤 됩니다.
리드-솔로몬 코드는 섀넌 한계에 더 가깝지만 확장성이 없고, 선형보다 느리며, 데이터에 비해 제곱이나 세제곱으로 더 많은 연산이 필요합니다.
터보 코드와 LDPC는 성능이 더 떨어지지만 훨씬 빠릅니다. 그래서 리드-솔로몬 코드보다 못하더라도 실제로는 더 이상적입니다.
리드-솔로몬 속도는 상황에 따라 크게 달라집니다. 적당히 신뢰할 만한 기반(예: 디스크의 파일 저장) 위에서 합리적인 크기의 코드로 최악의 경우를 복구하는 흔한 사례라면, 인코딩은 결과를 쓰는 곳(RAM, 디스크, 네트워크)의 대역폭이 병목이고, 일반적인 디코딩은 그냥 이어 붙이는 것에 불과하며, 최악의 경우의 디코딩도 이미 풀어 둔 행렬 분해를 캐시에서 꺼내 와서 회선 속도로 디코딩합니다.
특히 행렬 곱셈을 벡터화된 XOR의 연속으로 다시 쓸 수 있게 해 주는 요령이 있습니다. 다른 구현과 같은 수의 명령어 워드를 처리하면서(제어 흐름은 가감하고), 데이터 의존성이 전혀 없는 벡터화 연산의 흐름을 실행 유닛이 풍부하게 지원하는 방식으로 돌리는 거죠. 욕심을 내자면 공통 부분식 제거(CSE)를 하고 XOR 수가 최소가 되도록 행렬 상수를 고를 수도 있습니다.
그런 것 없이 기본적인 AVX2 요령만으로도 초당 몇 GiB는 나옵니다.
말씀하신 더 비싼 행렬 연산이 데이터 크기가 아니라 코드 크기를 n으로 놓은 것이라면 이야기가 다르겠지만요?
이 한 줄에 당신의 가정이 다 드러난다고 봅니다.
RAID-6나 다른 파일시스템은 아주 작은 리드-솔로몬 코드를 쓰니까 이런 캐싱 방식이 가능합니다.
하지만 적당한 크기(LDPC 기준으로 적당한 크기)의 65535 크기 리드-솔로몬 문제를 생각해 봅시다(2^16 비트에 들어가는 최대 리드-솔로몬입니다). 중복도가 1%뿐이어도 패리티가 655개입니다.
이제 풀어야 할 오류의 경우를 생각해 보세요. 소거(erasure)가 20개라면 캐시해야 할 행렬 조합이 대략 65535 choose 20개입니다.
즉 소거 20개를 처리하려면 미리 풀어서 캐시해야 하는 행렬이 대략 10^77개입니다. 사실상 불가능하죠.
하드 드라이브 40개를 두고 많아야 오류 3~4개를 다루는 경우라면, 물론 캐싱이 좋고 모든 걸 해결해 줍니다.
리드-솔로몬은 완벽한 최대 거리 분리(MDS) 코드입니다. 작은 n에서는 완벽하죠.
하지만 n이 크거나 적당한 정도만 되어도(패킷에서는 킬로바이트 단위) 너무 다루기 힘듭니다. LDPC와 터보 코드(불완전한 코드)가 그 틈을 메우고, 완벽함을 포기하기만 하면 더 큰 크기도 가능하게 해 줍니다.
음, 이제 이해가 갈 것 같네요. 데이터 크기가 클수록 더 큰 코드를 쓰자는 말씀이시죠? (예컨대 드라이브의 경우처럼 보통 데이터 스트라이프가 있고, 신경 써야 할 장애 유형이 하드 드라이브 전체를 잃는 것이라고 가정해서 스트라이프를 드라이브들에 분산하는 방식과는 다르게요)
흥미롭게도 비트 플립 확률이 꽤 높은 경우에는, 작은 코드를 반복해서 쓰는 것이 추가 오버헤드는 적으면서 오류 처리는 더 낫습니다(긴 메시지에 정정 불가능한 오류가 생길 확률이 낮아지니까요). 비트 플립 확률이 10%라면 GF256 위의 253+2 코드조차 비교적 괜찮아 보입니다(전체적으로는 끔찍하지만, 말씀하신 더 큰 코드보다는 낫습니다. 실제로 쓰이는 영역에서는 당신의 코드가 더 말이 된다고 생각해요).
기본적으로 맞습니다.
이더넷 프레임은 MTU가 1500바이트 언저리입니다. 점보 프레임이라면 8000바이트쯤이겠고요.
전통적으로 "Fire 코드"는 패킷 전체에 걸쳐 빠른 속도로 오류 정정을 해 줄 수 있었습니다( https://en.wikipedia.org/wiki/Burst_error-correcting_code#Fire_codes ). 리드-솔로몬(혹은 LDPC/터보 코드)만큼 좋지는 않지만, 1000에서 8000바이트의 "오류 정정 데이터"가 현실에서는 꽤 실용적이라는 감을 잡기에는 충분할 겁니다(예컨대 많은 시스코 스위치나 라우터가 순방향 오류 정정으로 Fire 코드에 의존합니다).
참고로 32비트 Fire 코드는 하나의 32비트 "버스트" 안에 전부 들어 있는 오류만 막아 줄 수 있습니다. "나쁜" 코드지만 속도는 매우 빠릅니다. Fire 코드는 멀리 떨어져 흩어진 두 개의 무작위 오류는 절대 막지 못합니다. "순수한" 버스트 오류 정정 방식이니까요.
더 최근의 이더넷 표준(예: 802.11)으로 가면 LDPC나 터보 코드를 쓰는 경향이 있습니다. 802.11의 MTU가 얼마인지는 모르지만 이쪽도 1000에서 8000바이트 영역일 거라고 짐작합니다.
65535 크기는 16비트 리드-솔로몬을 쓰는 Parchive의 한계입니다. 실제로 그 정도까지 커지지는 않지만, 그래도 RAID6 같은 시나리오에서 쓰이는 것보다는 훨씬 큰 오류 정정(혹은 소거 정정) 코드를 다루게 됩니다.
전부 실용적입니다. 다만 터보 코드/LDPC가 빛을 발하는 영역은, 리드-솔로몬의 O(n^2.5)(어쩌고)가 탈락 사유가 되는 훨씬 더 큰 코드입니다. "Pararchive"를 오늘날의 기술로 다시 쓴다면 터보 코드나 LDPC가 되지 않을까 싶습니다.
고전적인 RS 코드가 어떻게 터보 코드(나 LDPC)를 이긴다는 건지 모르겠습니다. 후자의 핵심 혁신 중 하나가 소프트 디코딩, 즉 들어오는 비트마다 불확실성의 정도가 다른 것을 다룰 수 있다는 점입니다. 어떤 비트가 0이라고 100% 확신하는 것보다(사실은 1이어야 할 때) 51%만 확신한다고 말하는 편이 훨씬 낫죠! 이건 라디오 같은 아날로그 시스템에서 특히 중요한데, 들어오는 비트에 자연스럽게 신뢰도 값이 따라오기 때문입니다.
RS 코드에도 소프트 버전이 있지만, 훨씬 나중에 나왔고 터보/LDPC 디코더가 쓰는 것과 같은 반복 기법을 사용합니다.
그건 섀넌 한계 논의와는 상관없는 이야기입니다.
리드-솔로몬 코드는 말 그대로 완벽합니다. 수학적으로 말하면 최대 거리 분리 코드(MDS)입니다( https://en.wikipedia.org/wiki/Singleton_bound ).
터보 코드와 LDPC는 이 성질을 만족하지 못하는, 증명된 불완전 코드입니다. 하지만 완벽에 아주 가깝습니다(실제로는 99.999999% 정도 완벽하죠).
리드-솔로몬의 문제는 행렬 분해/사실상의 행렬 역행렬 계산입니다. 예컨대 16비트, 즉 원소 65536개쯤 이상에서는 리드-솔로몬을 돌리는 게 기본적으로 불가능합니다(그 시점에서 2바이트이니 128kB). 이걸 풀 행렬이 65536 x 65536 x 2바이트, 대략 8Gb쯤이 되기 때문입니다.
음, 현대 컴퓨터는 8GB쯤은 감당하겠네요 ㅋㅋ. 그래도 요점은 아실 겁니다. O(n^2)이 문제라는 거죠.
LDPC와 터보 코드는 선형입니다. 그래서 4MB LDPC는, 뭐랄까... 현대 컴퓨터에서 실제로 가능합니다... 반면 4MB 리드-솔로몬 코드는 디코딩 행렬을 만드는 데만 엑사바이트 단위가 필요합니다. (32비트 곱하기 4MB의 제곱, 대충 그런 식으로요.)